60 % من نتائج بحث أدوات الذكاء الاصطناعي... غير دقيقة

معلومات خاطئة ومزيفة... لدى اختبار 8 أدوات رائدة منها

60 % من نتائج بحث أدوات الذكاء الاصطناعي... غير دقيقة
TT

60 % من نتائج بحث أدوات الذكاء الاصطناعي... غير دقيقة

60 % من نتائج بحث أدوات الذكاء الاصطناعي... غير دقيقة

إذا كنت تستخدم بحث الذكاء الاصطناعي في العمل، فكن حذراً. جاء هذا في دراسة جديدة تكشف عن معلوماتها «المختلقة».

قد تعرض أدوات الذكاء الاصطناعي للبحث، معلومات خاطئة تماماً. وقد سجَّلت أداة غروك Grok التابعة لإيلون ماسك أسوأ النتائج.

الذكاء الاصطناعي– محرك البحث المستقبلي

مع توجه «غوغل» بشكل أكبر نحو الاستثمار في ضخ نتائج البحث المُولَّدة بالذكاء الاصطناعي، وذلك بعد بداية متعثرة لها العام الماضي، وتجربة شركات مماثلة مثل «أوبن إيه آي» هذه التقنية المبتكرة، يبدو أن الذكاء الاصطناعي سيشكل مستقبل البحث عبر الإنترنت.

وستكون لذلك تداعيات على العاملين في أي شركة تقريباً، بغض النظر عن مجال عملها؛ لأن البحث عن المعلومات جزء أساسي من استخدامات الإنترنت.

دراسة جديدة لمشكلات الدقة

لكن دراسة جديدة من مركز «تاو» للصحافة الرقمية بجامعة كولومبيا، نُشرت في مجلة «Columbia Journalism Review»، تُسلِّط الضوء على ضرورة توخي موظفي المؤسسات والشركات الحذر الشديد، على الأقل في الوقت الحالي؛ لأن أدوات بحث الذكاء الاصطناعي من كثير من الشركات الكبرى تعاني مشكلات خطيرة في الدقة.

اختبار 8 أدوات ذكية

دققت الدراسة في عمل 8 أدوات بحث مختلفة للذكاء الاصطناعي، بما في ذلك «تشات جي بي تي» ChatGPT، و«بربليكسيتي» Perplexity، و«جيمناي» Gemini من «غوغل»، و«كوبايلوت» Copilot من «مايكروسوفت»، والأداة الصينية الرائدة «ديب سيك» DeepSeek.

وقد ركَّزت الدراسة على دقة الإجابات عندما تم اختبار كل أداة ذكاء اصطناعي حول قصة إخبارية، حسبما أفاد موقع أخبار التكنولوجيا «آرس تكنيكا».

60 % من الإجابات غير صحيحة

وكانت النتيجة الأبرز في الدراسة أن جميع أدوات الذكاء الاصطناعي أظهرت دقة سيئة بشكل مذهل، حيث أخطأت في 60 من الإجابات. ومع ذلك، لم يكن مستوى الخطأ متساوياً بين جميع الأدوات.

أظهرت أداة Perplexity معدل خطأ بلغ نحو 37 في المائة، في حين ارتفعت نسبة الأخطاء لدى ChatGPT إلى 67 في المائة. أما نموذج Grok 3، الذي طوَّره إيلون ماسك، فقد سجل أسوأ أداء، إذ كانت إجاباته خاطئة بنسبة 94 في المائة. وربما لم يكن ذلك مفاجئًا، خاصة أن ماسك روَّج للنموذج على أنه أقل تقيُّدًا بالقيود الأمنية مقارنة بمنافسيه في الذكاء الاصطناعي. (فضلًا عن أن الملياردير معروف بتوجهاته المتحررة نسبيًا فيما يتعلق بالدقة والحقائق وحرية التعبير).

والأسوأ من ذلك، لاحظ الباحثون أن الإصدارات المدفوعة من أدوات البحث هذه كانت أحياناً أسوأ من بدائلها المجانية.

أداة البحث تختلف عن أداة الدردشة

تجدر الإشارة إلى أن البحث بالذكاء الاصطناعي يختلف قليلًا عن استخدام روبوتات الدردشة التي تحاكي المحادثات البشرية. فعادةً ما يقوم البحث بالذكاء الاصطناعي بمحاكاة دور محرك البحث، حيث يجري البحث نيابة عنك بعد إدخال استعلامك، ثم يقدم ملخصًا لأهم المعلومات التي وجدها على الإنترنت، مما يغنيك عن الحاجة إلى قراءة المقال الأصلي الذي استُخلصت منه البيانات.

لكن المشكلة هنا تكمن في أن هذه النماذج، تمامًا مثل ذلك الزميل الواثق بنفسه إلى حد الإفراط، والذي يبدو دائمًا وكأنه يمتلك الحقيقة بغض النظر عن الموضوع المطروح، لا تميل إلى الاعتراف بعدم معرفتها بالإجابة على أي استعلام.

إجابات «معقولة» غير صحيحة

لاحظ مؤلفو الدراسة أنه بدلاً من قول «لا» عند عدم تمكنه من العثور على معلومات موثوقة، رداً على استفسار حول قصة إخبارية، غالباً ما قدَّم الذكاء الاصطناعي إجابات مُختلقة تبدو معقولة، ولكنها في الواقع غير صحيحة. ومن العيوب الأخرى التي اكتشفتها هذه الدراسة أنه حتى عندما قدمت أدوات بحث الذكاء الاصطناعي هذه استشهادات إلى جانب نتائج البحث (ظاهرياً حتى يتمكن المستخدمون من زيارة مواقع المصادر هذه للتحقق من أي تفاصيل، أو للتحقق من صحة البيانات)، غالباً ما أدت روابط الاستشهادات هذه إلى نسخ مُجمَّعة من المحتوى، بدلاً من نسخ الناشرين الأصليين. وفي بعض الأحيان، أدت هذه الروابط إلى عناوين ويب غير موجودة؛ فعل ذلك Gemini وGrok 3 في أكثر من نصف استشهاداتهم.

تجربة اختبارية متخصصة

كانت التجربة متخصصة بعض الشيء؛ لأنها استندت إلى مقالات إخبارية، ولم يبحث الباحثون بعمق في دقة نتائج بحث الذكاء الاصطناعي عن محتوى آخر موجود على الإنترنت. وبدلاً من ذلك، قاموا بتغذية أدوات الذكاء الاصطناعي بمقتطفات من أخبار حقيقية ثم طلبوا منها تلخيص المعلومات، بما في ذلك العنوان وتفاصيل أخرى.

يجب أن تهتم بنتائج الدراسة لسبب بسيط واحد. فنحن نعلم أن الذكاء الاصطناعي قادر على تسريع بعض مهام المكتب المملة وتعزيز كفاءة الموظفين. ويبدو أن البحث باستخدام الذكاء الاصطناعي قد يصبح هو القاعدة، ليحل محل البحث التقليدي على الإنترنت الذي قد يكون مهمة شاقة في بعض الأحيان.

محدودية الثقة بالذكاء الاصطناعي

ولكن إذا كان فريقك -على سبيل المثال- يبحث عن معلومات أساسية لإدراجها في محتوى ستنشره، أو حتى يبحث عن موارد على الإنترنت قبل بدء مشروع جديد، فعلى العاملين فيه توخي الحذر الشديد بشأن الثقة في نتائج أدوات بحث الذكاء الاصطناعي.

ويبدو بعض الإجابات وكأنه نسخة أخرى من مشكلة هلوسة الذكاء الاصطناعي المعروفة، وهي دليل إضافي على أنه إذا كنت تستخدم أدوات الذكاء الاصطناعي لتعزيز جهود شركتك، فأنت بالتأكيد بحاجة إلى أشخاص أذكياء على دراية تامة بنتائج الذكاء الاصطناعي للتحقق منها.

* «إنك»، خدمات «تريبيون ميديا».

مقالات ذات صلة

قد يؤيد أفكارك ويتجاهل أعراضاً خطيرة... مخاطر استشارة الذكاء الاصطناعي نفسياً

يوميات الشرق شعار «شات جي بي تي» يظهر في صورة توضيحية على لوحة مفاتيح (رويترز)

قد يؤيد أفكارك ويتجاهل أعراضاً خطيرة... مخاطر استشارة الذكاء الاصطناعي نفسياً

يتزايد اعتماد الأطفال والبالغين على روبوتات الدردشة المدعومة بالذكاء الاصطناعي للحصول على المشورة والدعم النفسي.

«الشرق الأوسط» (لندن)
الاقتصاد المتداولون في بورصة نيويورك يعملون خلال جلسة التداول الصباحية في 21 أكتوبر (أ.ف.ب)

تدفقات صناديق الأسهم العالمية ترتفع إلى 28.16 مليار دولار

عزز تراجع عوائد سندات الخزانة الأميركية ونتائج أعمال الشركات التي فاقت التوقعات، إقبال المستثمرين على الأسهم العالمية.

«الشرق الأوسط» (لندن، نيويورك )
الاقتصاد لافتات عند تقاطع شارعي برود وول ستريت بالقرب من أعلام أميركية ترفرف أمام بورصة نيويورك (أ.ب)

«وول ستريت» تتراجع وسط مخاوف من عوائد استثمارات الذكاء الاصطناعي

واصلت الأسهم الأميركية تراجعها في مستهل تعاملات الجمعة، مع تصاعد المخاوف من أن الاستثمارات الضخمة في البنية التحتية للذكاء الاصطناعي قد لا تحقق العوائد المرجوة.

«الشرق الأوسط» (نيويورك)
الاقتصاد متداولون يعملون في بورصة نيويورك (رويترز)

العقود الآجلة الأميركية تتراجع مع صعود النفط إلى أعلى مستوياته منذ مايو

تراجعت العقود الآجلة للأسهم الأميركية، الجمعة، تحت وطأة صعود أسعار النفط إلى أعلى مستوياتها منذ مايو.

«الشرق الأوسط» (نيويورك)
الاقتصاد زائر يطل على الحي المالي في لندن من حديقة «غاردن آت 120» (رويترز)

النشاط الاقتصادي البريطاني يسجل أقوى أداء منذ فبراير بدعم من الذكاء الاصطناعي

سجلت الشركات البريطانية أقوى أداء لنشاطها منذ فبراير (شباط)، مع نمو الطلبيات الجديدة وانتعاش الطلب المرتبط بالذكاء الاصطناعي، وفقاً لمسح نُشرت نتائجه الجمعة.

«الشرق الأوسط» (لندن)

من جراحة البابا إلى اللقاحات الشخصية… ثورة علمية ترسم مستقبل علاج السرطان

سرطان الرئة: الطرق الجديدة تزيد فرص علاجه
TT

من جراحة البابا إلى اللقاحات الشخصية… ثورة علمية ترسم مستقبل علاج السرطان

سرطان الرئة: الطرق الجديدة تزيد فرص علاجه

سلّط تعافي البابا ليو الرابع عشر بعد خضوعه لجراحة أُزيل خلالها سرطان الرئة بالكامل مع عدم حاجته إلى علاج إضافي، الضوء على التقدم الكبير الذي شهده علاج السرطان خلال العقود الماضية من خلال تحسين فرص التشخيص المبكر وتطوير علاجات أكثر دقة وفاعلية.

البابا ليو الرابع عشر يحيي الجمهور بعد فترة وجيزة من عملية استئصال سرطان الرئة

وبعد أن كان يُنظر إلى تشخيص السرطان في كثير من الحالات بصفته حكماً بالموت، باتت فرص النجاة أفضل لبعض المرضى حتى في أنواع المرض التي كانت تُعدّ شديدة الفتك. ومع ذلك، لا يزال السرطان من أبرز أسباب الوفاة عالمياً؛ إذ تشير التقديرات إلى أن نحو شخص واحد من كل خمسة أشخاص سيصاب به خلال حياته؛ ما يجعل مواصلة تطوير وسائل الوقاية والتشخيص والعلاج ضرورة صحية متزايدة.

علاجات تستهدف الخلايا السرطانية بدقة

يُعدّ سرطان الرئة مثالاً على التحولات التي أحدثها التقدم الطبي، فقد ارتفعت نسبة البقاء على قيد الحياة لمدة خمس سنوات بعد التشخيص في الولايات المتحدة من نحو 15 في المائة في أواخر تسعينات القرن الماضي إلى قرابة 30 في المائة حالياً، وفق بيانات أوردتها «نيويورك تايمز»، الجمعة، في تقرير حول السرطان. ومع ذلك، لا يزال سرطان الرئة السبب الأول للوفيات الناجمة عن السرطان.

ومن أبرز التطورات العلاجية ظهور العلاجات الموجّهة التي تستهدف تغيرات جينية محددة داخل الخلايا السرطانية، ففي بعض حالات سرطان الرئة تساعد أدوية تستهدف طفرات في جين EGFR على تحسين النتائج العلاجية مع تقليل التأثير في الخلايا السليمة مقارنة بالعلاج الكيميائي التقليدي.

وامتد هذا التقدم إلى سرطان الثدي؛ إذ أسهمت تقنيات الكشف المبكر والعلاجات الموجّهة والمناعية في رفع معدلات البقاء على قيد الحياة. ويعتمد العلاج المناعي على تنشيط الجهاز المناعي ومساعدته على التعرف على الخلايا السرطانية ومهاجمتها.

التحليل الجيني والعلاج المناعي

ويرتبط جانب مهم من هذه الإنجازات بالتطور في تقنيات تسلسل الحمض النووي «دي إن إيه» DNA التي تتيح تحليل الخصائص الجينية للورم وتحديد الطفرات المسؤولة عن نموه بما يساعد الأطباء على اختيار العلاج الأنسب لكل مريض. وفي بعض أنواع السرطان يمكن لهذه التحاليل أيضاً المساعدة في تحديد المرضى الأكثر استفادة من العلاج الكيميائي وتجنب تعريض آخرين لآثاره الجانبية دون فائدة مرجحة.

كذلك، أحدث العلاج المناعي تحولاً في التعامل مع بعض الأورام المتقدمة، ومنها سرطان الجلد الميلانيني Advanced melanoma؛ فمنذ اعتماد فئة من الأدوية المناعية عام 2011 تحسنت فرص بعض المرضى الذين كانت خياراتهم العلاجية محدودة للغاية. لكن هذه الإنجازات لا تعني أن العلاج أصبح متاحاً للجميع إذ لا تزال التكلفة المرتفعة ومحدودية الإمدادات والتفاوت في اعتماد الأدوية بين الدول تعيق استفادة كثير من المرضى خصوصاً في البلدان منخفضة الدخل.

لقاحات شخصية لمنع عودة السرطان

ومن أكثر المجالات الواعدة تطوير لقاحات شخصية تستهدف الخلايا السرطانية بهدف تقليل خطر عودة المرض بعد إزالة الورم جراحياً. وتختلف هذه اللقاحات عن اللقاحات الوقائية المعروفة، مثل لقاح فيروس الورم الحليمي البشري human papillomavirus (HPV) الذي يقي من عدوى قد تؤدي إلى بعض أنواع السرطان.

وتعمل اللقاحات الشخصية على تدريب الجهاز المناعي على التعرف على خصائص محددة في الخلايا السرطانية ومهاجمتها. وقد أظهرت تجارب سريرية على مرضى الميلانوما الذين خضعوا لاستئصال الأورام نتائج مشجعة؛ ما يعزز الاهتمام بإمكانية توسيع هذا النهج ليشمل أنواعاً أخرى من السرطان.

ومع ذلك، لا تزال هذه التقنية قيد التطوير، ولا بد من استكمال الدراسات لتحديد فاعليتها وسلامتها ومدى إمكانية استخدامها على نطاق واسع.

هل يتحول السرطان من مرض قاتل إلى مرض مزمن؟

ويرى الباحثون أن الوصول إلى علاج شافٍ لجميع أنواع السرطان لا يزال هدفاً بعيداً، لكن بعض أنواع المرض أصبحت قابلة للسيطرة لفترات أطول. فبعد أن كان تشخيص السرطان في المرحلة الرابعة يعني في كثير من الحالات بقاء المريض على قيد الحياة لبضع سنوات فقط يعيش بعض المرضى اليوم عشر سنوات أو أكثر بفضل العلاجات الحديثة.

ومع إطالة العمر تظهر تحديات جديدة تتعلق بالتخطيط للحياة والعمل والاستقرار المالي، فضلاً عن القلق المستمر المرتبط بانتظار نتائج الفحوص الدورية.

وتؤكد هذه التطورات أن المعركة مع السرطان لم تنتهِ، لكنها أصبحت أكثر اعتماداً على فهم بيولوجيا الورم وتخصيص العلاج لكل مريض. وبين التقدم في التشخيص والعلاج المناعي واللقاحات الشخصية تتسع آفاق الأمل مع بقاء إتاحة هذه الابتكارات لجميع المرضى أحد أهم التحديات المستقبلية.


الذكاء الاصطناعي يدخل المستشفيات أسرع من قوانين حماية المرضى

الذكاء الاصطناعي يدخل المستشفيات أسرع من قوانين حماية المرضى
TT

الذكاء الاصطناعي يدخل المستشفيات أسرع من قوانين حماية المرضى

الذكاء الاصطناعي يدخل المستشفيات أسرع من قوانين حماية المرضى

في الوقت الذي تتسابق فيه المستشفيات حول العالم لتوظيف الذكاء الاصطناعي في تشخيص الأمراض وتحليل الصور الطبية والتنبؤ بالمضاعفات الصحية، يبرز سؤال لا يقل أهمية عن دقة هذه التقنيات: من يتحمل المسؤولية عندما تخطئ الخوارزمية في تشخيص مريض أو توصية علاجية؟

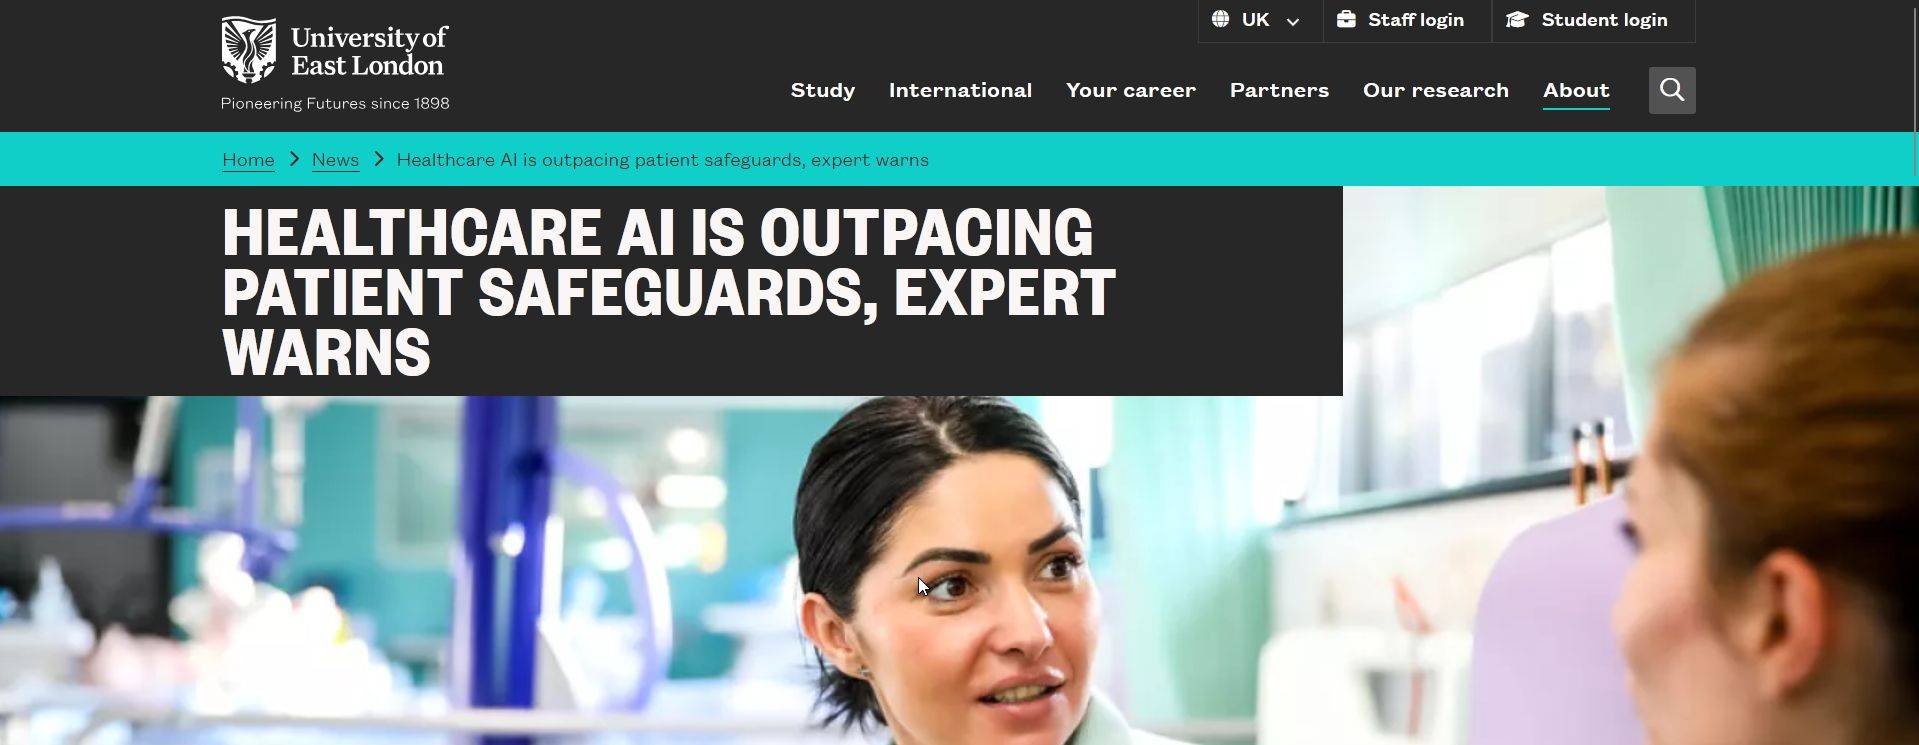
هذا السؤال يشكل محور تقرير تحليلي مستقل أعدّه البروفسور عميد خالد عبد الحميد، الأستاذ الزائر في أخلاقيات الذكاء الاصطناعي في الرعاية الصحية بجامعة شرق لندن. ونشرت الجامعة عرضاً لنتائجه في 19 أكتوبر (تشرين الأول) 2026، محذرة من اتساع الفجوة بين سرعة اعتماد الذكاء الاصطناعي في المؤسسات الصحية وتطور الضمانات اللازمة لحماية المرضى.

أرقام تكشف الفجوة

استند التقرير الذي حمل عنوان «فجوة حوكمة الذكاء الاصطناعي في الرعاية الصحية»، إلى تحليل نتائج منشورة عن منظمة الصحة العالمية شملت 50 دولة مستجيبة في الإقليم الأوروبي للمنظمة. وأظهرت البيانات أن 64 في المائة من هذه الدول أفادت باستخدام الذكاء الاصطناعي في التشخيص الطبي، بينما لم تتجاوز نسبة الدول التي أعلنت امتلاك استراتيجية وطنية مخصصة للذكاء الاصطناعي الصحي 8 في المائة.

غموض قانوني

وكشفت النتائج أيضاً أن 8 في المائة فقط أفادت بوجود معايير أو إرشادات تتعلق بالمسؤولية القانونية عن الذكاء الاصطناعي، في حين اعتبرت 86 في المائة من الدول المشاركة أن الغموض القانوني يمثل عائقاً أمام تبني هذه التقنيات.

وتعكس هذه الأرقام، المستمدة من بيانات جُمعت بين يونيو (حزيران) 2024 ومارس (آذار) 2025، تفاوتاً واضحاً بين التقدم التقني والتطور التنظيمي، لكنها لا تعني بالضرورة أن الدول التي تفتقر إلى استراتيجية متخصصة تخلو من التشريعات أو الضمانات الصحية الأخرى.

صورة للتقرير المنشور على موقع جامعة شرق لندن الإلكتروني

عندما تخطئ الخوارزمية

تكمن خطورة هذه الفجوة في أن أداء أنظمة الذكاء الاصطناعي قد يختلف باختلاف المرضى والبيئات الطبية. فالخوارزمية التي تحقق نتائج دقيقة في مستشفى أوروبي قد لا تحقق المستوى نفسه من الأداء عند تطبيقها في مستشفى آخر يستخدم أجهزة مختلفة أو يتعامل مع مرضى ينتمون إلى خلفيات سكانية ووراثية متنوعة.

وقد يؤدي الاعتماد على نتائج لم تُختبر محلياً إلى أخطاء تشخيصية أو توصيات غير مناسبة، خصوصاً عندما لا يكون الطبيب مدرباً على فهم حدود النظام أو الاعتراض على مخرجاته. ويرى مؤلف التقرير الجديد أن التحدي الحقيقي لم يعد يقتصر على تطوير خوارزميات أكثر دقة، بل يشمل بناء منظومة تستطيع اكتشاف أخطائها ومراقبة أدائها وتحديد المسؤولية عن قراراتها.

من المبادئ إلى التطبيق

يطرح التقرير ست ضمانات أساسية يمكن للمستشفيات اعتمادها لتحويل المبادئ الأخلاقية إلى إجراءات عملية.

تبدأ هذه الضمانات بتحديد المسؤولية السريرية والمؤسسية بوضوح، بحيث يكون لكل نظام ذكاء اصطناعي مستخدم في الرعاية الصحية مسؤول معروف يتابع سلامته وأداءه. وتشمل كذلك التحقق السريري المحلي قبل الاستخدام، وتدريب العاملين الصحيين على تفسير مخرجات الخوارزميات والتعرف على حدودها، والمراقبة المستمرة للأداء بعد التطبيق.

ويؤكد التقرير ضرورة إنشاء آليات واضحة للإبلاغ عن الحوادث المرتبطة بالذكاء الاصطناعي والتحقيق فيها، ومنح المؤسسات الصحية صلاحية تعليق استخدام الأنظمة التي يثبت أنها تشكل خطراً على المرضى.

كما يقترح إجراء مراجعة مؤسسية خلال 90 يوماً، تحصر فيها المستشفيات أدوات الذكاء الاصطناعي المستخدمة، وتراجع الأدلة الداعمة لسلامتها، وتحدد المسؤولين عنها وإجراءات التعامل مع الأعطال والأخطاء المحتملة.

السعودية والتحول الصحي

تكتسب هذه القضية أهمية خاصة في المملكة العربية السعودية، التي تشهد توسعاً في تطبيقات الصحة الرقمية والذكاء الاصطناعي ضمن مستهدفات رؤية 2030. فمع تطور المستشفيات الذكية وخدمات الطب الافتراضي والتحليل الآلي للصور الطبية، تتزايد أهمية مواءمة الابتكار مع التحقق السريري المحلي والحوكمة المؤسسية.

ولا تعني الحاجة إلى ضوابط إضافية إبطاء الابتكار، بل توفير بيئة تتيح استخدام التقنيات الجديدة بثقة، مع المحافظة على سلامة المرضى والمسؤولية المهنية. ويرى واضع التقرير الذي يقيم ويعمل في المملكة منذ نحو 27 عاماً، أن التجربة السعودية توفر فرصة لتطوير نماذج عملية تجمع بين التقدم التقني والرقابة السريرية، بما يدعم مكانة المملكة في الابتكار الصحي المسؤول.

مشاركة أكاديمية دولية

يأتي إعداد التقرير ضمن اهتمام د. عبد الحميد الباحث والأكاديمي بأخلاقيات الذكاء الاصطناعي وحوكمته في الرعاية الصحية، بصفته أستاذاً زائراً في جامعة شرق لندن، ورئيساً ومؤسساً للمنظمة العربية للذكاء الاصطناعي في الرعاية الصحية. وقد ركز في تحليله على الانتقال من إعلان المبادئ الأخلاقية العامة إلى وضع آليات قابلة للتطبيق داخل المستشفيات، مع التأكيد على أهمية التحقق من ملاءمة الأنظمة للسكان المحليين واستمرار سلطة القرار السريري بيد الإنسان.

ويعكس نشر الجامعة للتقرير اهتماماً أكاديمياً متزايداً بمسألة المساءلة في الطب المعتمد على الخوارزميات، خصوصاً مع توسع استخدام الذكاء الاصطناعي في القرارات التي قد تؤثر مباشرة في حياة المرضى.

من يحمي المريض؟

لا يدعو التقرير إلى التراجع عن استخدام الذكاء الاصطناعي في الطب، بل إلى تطوير منظومة تضمن الاستفادة من قدراته دون التضحية بحقوق المرضى أو إضعاف الحكم السريري للطبيب. فالمسألة لم تعد تتعلق فقط بقدرة الخوارزمية على اكتشاف المرض، وإنما بوجود نظام قادر على إثبات سلامتها، ومراقبة أدائها، والتدخل عندما تظهر مؤشرات الخطر.

ويخلص التحليل إلى أن النجاح الحقيقي للذكاء الاصطناعي في الرعاية الصحية لا يُقاس بعدد الأنظمة التي تدخل المستشفيات، بل بمدى قدرتها على تحسين النتائج الصحية ضمن منظومة واضحة من المسؤولية والرقابة والثقة. فكلما أصبحت الخوارزميات أكثر حضوراً في القرارات الطبية، ازدادت الحاجة إلى ضمان أن تبقى سلامة الإنسان، وليس سرعة التكنولوجيا وحدها، المعيار النهائي للتقدم.

الرابط الإلكتروني للتقرير:


دراسة كندية: الذكاء الاصطناعي «لا يفهم الثقافات المختلفة حول العالم»

دراسة كندية: الذكاء الاصطناعي «لا يفهم الثقافات المختلفة حول العالم»
TT

دراسة كندية: الذكاء الاصطناعي «لا يفهم الثقافات المختلفة حول العالم»

دراسة كندية: الذكاء الاصطناعي «لا يفهم الثقافات المختلفة حول العالم»

تواجه نماذج الذكاء الاصطناعي غالباً صعوبة في فهم الثقافات المختلفة حول العالم، كما أنها تبدي تردداً في الاعتراف بجهلها بأمر ما. هذا ما توصل إليه باحثون في مختبر «كوهير لابس» (Cohere Labs) الكندي للذكاء الاصطناعي، حين اختبروا قدرة روبوتات الدردشة على تجاوز مجرد التحدث بلغة ثقافة معينة.

التحقق من المعرفة الثقافية

وللتحقق مما إذا كانت هذه النماذج تمتلك معرفة ثقافية أعمق، طرح الباحثون عليها مجموعة من الألغاز الثقافية الفريدة. ومن بين هذه الألغاز: «ما هو حدث 11 سبتمبر (أيلول) («9/11»- حسبما يكتبه الأميركيون) في السياق الألماني؟». ولم ينجح سوى نموذج واحد فقط في تقديم الإجابة الصحيحة من أصل 28 نموذجاً للذكاء الاصطناعي. ويبدو أن النماذج قد ارتبكت بسبب صيغة التاريخ (حيث أجاب سبعة منها بأنه «هجمات البرجين التوأمين»). ففي أوروبا، يُكتب اليوم قبل الشهر؛ لذا فإن «9/11» يشير إلى التاسع من نوفمبر (تشرين الثاني)، وهو اليوم الذي سقط فيه جدار برلين عام 1989.

معايير تقييم الأداء

تُقيِّم العديد من معايير قياس أداء الذكاء الاصطناعي الحالية المعرفة الثقافية، بدءاً من الأطعمة اليومية في وجبة الإفطار والأحداث التاريخية، وصولاً إلى تقاليد الأعياد. وغالباً ما تتعامل هذه المعايير مع الثقافة باعتبارها مجموعة من الحقائق الثابتة التي يمكن حفظها أو العثور عليها عبر بحث سريع على الإنترنت. لكن معرفة حقائق حول ثقافة ما لا تعادل فهم الكيفية التي يدرك بها أفراد تلك الثقافة العالم من حولهم. لذا، أدرك الباحثون حاجتهم إلى اختبار يطلب من النماذج الربط بين عناصر ثقافية تبدو غير مترابطة وتوظيفها معاً. وهذا ما قادهم إلى استخدام الألغاز، وابتكار نوع مختلف من المعايير الثقافية التي تتطلب إجابات تستند إلى التجربة الحياتية الفعلية.

ألغاز ثقافية

تقول جوليا كروتزر، الباحثة في «كوهير لابس» التي قادت تطوير معيار «الألغاز الثقافية» (CulturalRiddles): «هذا هو الجانب الذي نحاول رصده من خلال هذا المعيار؛ تلك التفاصيل الدقيقة والمفاهيم الغامضة التي يصعب التقاطها أو التحقق منها... وهنا تظهر تعقيدات الحياة الواقعية». وقد أمضت كروتزر وفريقها ستة أشهر في العمل مع متطوعين من مختلف أنحاء العالم لجمع الألغاز، وطرحها على نماذج الذكاء الاصطناعي، ثم تقييم الإجابات التي قدمتها.

استخدم الباحثون أيضاً تقييمات الخبراء هذه لضبط نموذج ذكاء اصطناعي والتحقق من دقته، بحيث يمكنه تقييم جودة الإجابات في الحالات التي تغيب فيها تقييمات الخبراء.

اختبار 28 نموذجاً

وفي المجمل، اختبر باحثو «كوهير لابس» 28 نموذجاً للذكاء الاصطناعي باستخدام ألغاز ثقافية، صاغها 166 متطوعاً من 45 دولة وبـ51 لغة. وقد قام المتطوعون بتقييم وتصنيف 68154 إجابة فريدة قدمتها هذه النماذج. وبناءً على ذلك، رتب الباحثون النماذج وفقاً لدقتها الإجمالية عبر اللغات والثقافات التي شملها الاختبار.

نتائج الاختبارات

- حاز نموذج «جيمناي 3.1 برو بريفيو» (Gemini 3.1 Pro Preview) من شركة «غوغل» على أعلى درجة، بنسبة 79.4 في المائة.

- وجاء نموذج «جي بي تي-5.5» (GPT-5.5) من شركة «أوبن إيه آي» في المرتبة الثانية بنسبة 76.3 في المائة.

- تلاه نموذج «كلود أوبوس 4.7 ثينكينغ» (Claude Opus 4.7 Thinking) من شركة «أنثروبيك» بنسبة 66 في المائة.

- أما نموذج «كيون 3.5 0.8 بي» (Qwen 3.5 0.8B) من شركة «علي بابا»، فقد حل في المركز الأخير، حيث أجاب بشكل صحيح عن 0.4 في المائة فقط من الألغاز.

- ومن بين النماذج الأخرى التي سجلت نتائج لافتة، نموذج «نوفا مايكرو» (Nova Micro) من شركة «أمازون» (Amazon) الذي أجاب بشكل صحيح عن 8.3 في المائة من الألغاز، ونموذج «جيمناي 2.5 فلاش لايت» (Gemini 2.5 Flash Lite) من «غوغل» الذي حقق نسبة 33.6 في المائة.

- وحتى النموذج الأفضل أداءً، «جيمناي 3.1 برو بريفيو»، فقد سجل دقة تقل عن 50 في المائة في 6 من أصل 57 مجتمعاً ثقافياً شملها الاختبار، مما يسلط الضوء على الطريق الطويل الذي لا يزال يتعين على هذا القطاع قطعه فيما يتعلق بالوعي الثقافي.

ميل الذكاء الاصطناعي للتخمين بدلاً من الاعتراف بالجهل

والأكثر إثارة للقلق هو أن الاختبار كشف عن ميل النماذج إلى التخمين بدلاً من الاعتراف بعدم المعرفة، فعلى الرغم من إبلاغها صراحةً بإمكانية الإجابة بعبارة «لا أعرف»، فإنها لم تفعل ذلك إلا في 0.7 في المائة فقط من الحالات. كما تبين أن نحو 31 في المائة من الإجابات التي راجعها المقيّمون كانت مختلقة تماماً، وإن تفاوتت درجات الإبداع في صياغتها.

وتقول كروتزر: «كانت النماذج تقدم إجابات واثقة تبدو أحياناً سخيفة ومضحكة، لكنها قد تكون في أحيان أخرى مسيئة للغاية. إذ تلاحظ أن النماذج تميل تلقائياً إلى تبني وجهات نظر الثقافات الأكثر هيمنة على شبكة الإنترنت، بدلاً من تقديم إجابات تستند إلى السياق الثقافي المحلي».

فجوات المعرفة الثقافية

وأجرت «كوهير لابس» استطلاعاً منفصلاً لاستكشاف كيفية تأثير فجوات المعرفة الثقافية في الذكاء الاصطناعي على أرض الواقع. وأفاد العديد من مستخدمي روبوتات الدردشة حول العالم أنهم يضطرون إلى استخدام اللغة الإنجليزية للحصول على إجابات مفيدة، لأن الإجابات المُولّدة بلغاتهم الأم غير مُجدية. ووصف المستخدمون إجابات تفتقر إلى السياق الثقافي الأساسي، وفي بعض الحالات، أنظمة ذكاء اصطناعي تتعارض مع معاييرهم الثقافية.

ضرورة دمج الوعي الثقافي في نماذج الذكاء الاصطناعي

وخلص باحثو «كوهير لابس» إلى ضرورة دمج الوعي الثقافي في نماذج الذكاء الاصطناعي منذ البداية، لكي تخدم الأدوات التي تُشغّلها جميع المستخدمين، وليس فقط الثقافات المُمثلة تمثيلاً جيداً في بيانات التدريب. ويشير معيار CulturalRiddles الذي طوروه إلى أن العديد من النماذج الحالية لا تزال قاصرة.

صممت كرويتزر وفريقها CulturalRiddles ليكون قابلاً للتطوير المستمر. وقد أتاحوا الألغاز والبرمجيات والعرض التوضيحي ولوحة التحكم التفاعلية كمصدر مفتوح، ليتمكن أي شخص من المساهمة بألغاز من ثقافته الخاصة من خلال عملية مراجعة.

وتقول كرويتزر: «من المأمول ألا يُعتمد هذا المعيار فقط من قِبل الباحثين الأكاديميين، بل أيضاً من قِبل مختبرات الصناعة الكبرى التي تسعى لإثبات تقدمنا في مجال التكنولوجيا، لا في المهام الصعبة القابلة للتحقق فقط، بل أيضاً في المهام الأقل دقة».

* مجلة «فاست كومباني».