«GPT-Live» نموذج صوتي جديد من «أوبن إيه آي» يستمع ويتحدث في الوقت نفسه

يحوّل الصوت إلى واجهة أكثر تقدماً للذكاء الاصطناعي

يستطيع النموذج الاستماع والتحدث في الوقت نفسه بدلاً من انتظار انتهاء المستخدم من الكلام قبل الرد (شاترستوك)
TT

«GPT-Live» نموذج صوتي جديد من «أوبن إيه آي» يستمع ويتحدث في الوقت نفسه

يستطيع النموذج الاستماع والتحدث في الوقت نفسه بدلاً من انتظار انتهاء المستخدم من الكلام قبل الرد (شاترستوك)

أطلقت «أوبن إيه آي» جيلاً جديداً من نماذج الصوت باسم «جي بي تي لايف» (GPT-Live) في خطوة تهدف إلى جعل التحدث مع «تشات جي بي تي» أقرب إلى محادثة بشرية طبيعية، لا تبادل أوامر متقطعة بين المستخدم والنظام. ويبدأ طرح النموذج عالمياً داخل تجربة «ChatGPT Voice» عبر نسختين هما «GPT-Live-1» و«GPT-Live-1 mini» على أن يصل لاحقاً إلى واجهة البرمجة للمطورين والشركات.

الاستماع والتحدث معاً

الفرق الأساسي في النموذج الجديد أنه يعتمد على بنية تعرف باسم «full-duplex» أي أنه يستطيع الاستماع والتحدث في الوقت نفسه. في النماذج الصوتية السابقة، كان النظام ينتظر غالباً انتهاء المستخدم من الكلام قبل أن يبدأ في الرد، مما يجعل الحوار أقرب إلى جولات منفصلة. أما في النموذج الجديد، فيستطيع النظام متابعة الكلام، أو الصمت عندما يحتاج المستخدم إلى التفكير، أو الرد السريع، أو استخدام عبارات قصيرة تدل على أنه يتابع الحديث.

تقول «أوبن إيه آي» إن «GPT-Live» يستطيع اتخاذ قرارات تفاعلية مرات عدة في الثانية، مثل أن يتكلم أو يواصل الاستماع أو يتوقف أو يقاطع أو يستدعي أداة أخرى. هذا التحول مهم لأن كثيراً من الإحباط في تجارب الصوت السابقة كان ناتجاً عن سوء تقدير لحظة انتهاء الكلام، خصوصاً عند وجود توقف قصير أو ضوضاء في الخلفية.

يمكن للنموذج الاستعانة بنماذج أقوى في الخلفية عند الحاجة إلى تحليل أعمق أو تنفيذ مهام أكثر تعقيداً (رويترز)

تفاعل مستمر

توضح الشركة أن أجيالاً سابقة من أنظمة الصوت اعتمدت على سلسلة من النماذج المتتابعة أي نموذج يحول الكلام إلى نص، ثم نموذج لغوي ينتج الإجابة، ثم نموذج آخر يحول النص إلى صوت. هذه الطريقة فتحت الباب أمام المحادثة الصوتية مع نماذج متقدمة، لكنها كانت بطيئة نسبياً، وقد تفقد بعض المعلومات أثناء انتقالها بين النماذج.

أما «Advanced Voice Mode» فاختصر بعض هذه الخطوات عبر معالجة الصوت وإنتاجه داخل نموذج واحد، لكنه ظل قائماً على مبدأ الأدوار المنفصلة بين المستخدم والنظام. لذلك لم يكن الحوار دائماً بالمرونة نفسها التي تحدث في المحادثات البشرية، حيث يمكن للشخصين المقاطعة والتوضيح والتوقف والمتابعة بصورة طبيعية.

يحاول «GPT-Live» تجاوز هذا القيد عبر معالجة مستمرة للمدخلات الصوتية أثناء توليد الرد، مما يسمح بتدفق أكثر مرونة. وتقول الشركة إن ذلك يدعم أيضاً استخدامات مثل الترجمة المباشرة، لأن النظام لا يحتاج إلى انتظار انتهاء مقطع طويل قبل أن يبدأ في التعامل معه.

عقل أعمق في الخلفية

لا يقتصر التغيير على أسلوب الحوار حيث إن النموذج الجديد يفصل بين طبقة التفاعل الصوتي السريع والمهام التي تحتاج إلى تفكير أعمق أو بحث أو تنفيذ خطوات أكثر تعقيداً. عند الحاجة، يمكن لـ«GPT-Live» أن يحيل المهمة إلى نموذج أكثر تقدماً في الخلفية، مثل «GPT-5.5» عند الإطلاق، ثم يعيد النتيجة إلى المحادثة عندما تصبح جاهزة.

هذا التصميم يعالج مشكلة عملية في واجهات الصوت. فالمستخدم لا يريد أن تتحول كل مهمة صعبة إلى صمت طويل، ولا يريد في الوقت نفسه إجابة سطحية لمجرد الحفاظ على سرعة الحوار. لذلك يحاول النظام الجمع بين الاستجابة الصوتية السريعة والقدرة على الاستعانة بنموذج أقوى للبحث أو التحليل أو تنفيذ مهام أكثر تعقيداً.

وتشير «أوبن إيه آي» إلى أن هذا النهج قد يفتح لاحقاً المجال أمام استخدام الصوت في أعمال أطول وأكثر تعقيداً وذات طابع وكيل، حيث لا يكتفي النموذج بالرد، بل يساعد في إنجاز مهام متعددة أثناء استمرار المحادثة.

يهدف «GPT-Live» إلى تحسين سلاسة الحوار الصوتي خصوصاً عند المقاطعة أو التوقف أو وجود ضوضاء في الخلفية (رويترز)

تجربة جديدة داخل «تشات جي بي تي»

مع الطرح الجديد، يصبح «GPT-Live» المحرك الافتراضي لتجربة الصوت في «تشات جي بي تي». وستحصل خطط «Go» و«Plus» و«Pro» على: «GPT-Live-1» بينما تعتمد الخطة المجانية على «GPT-Live-1 mini». وتقول الشركة إن أكثر من 150 مليون شخص يستخدمون أسبوعياً ميزات مثل الصوت والإملاء داخل «تشات جي بي تي»، سواء للمساعدة اليومية من دون استخدام اليدين، أو ممارسة اللغات، أو المحادثة أثناء التنقل.

وتتضمن التجربة الجديدة قدرة أفضل على الاستماع في ظروف أقل مثالية، مثل وجود ضوضاء في الطريق أو محادثات قريبة، إضافة إلى إمكانية أن يطلب المستخدم من النظام أن ينتظر أو يصمت أو يبطئ إيقاعه. كما أعادت الشركة تحسين الأصوات التسعة المتاحة في «تشات جي بي تي» لتناسب النموذج الجديد.

وتضيف «أوبن إيه آي» أن الصوت سيستمر في دعم البحث والذاكرة والصور ورفع الملفات، مع إمكانية عرض بطاقات مرئية لبعض الإجابات، مثل الطقس أو الأسهم أو الرياضة، أثناء استمرار المحادثة الصوتية.

السلامة في محادثة فورية

لأن الصوت أكثر قرباً وحساسية من النص، خصصت الشركة جانباً من الإعلان لإجراءات السلامة. فقد وسّعت اختبارات النموذج لتشمل تقييمات صوتية مرتبطة بمخاطر مثل إيذاء النفس، والاعتماد العاطفي على الذكاء الاصطناعي، والعنف، والمحتوى الجنسي. كما تقول إن النظام يملك آليات يمكن أن تتدخل أثناء الكلام إذا رصدت مخرجات غير آمنة، إما بتوجيه الرد نحو مسار أكثر أماناً، أو عرض موارد دعم، أو إنهاء المحادثة في الحالات الأعلى خطراً.

وتقول الشركة أيضاً إن «GPT-Live» مصمم للمحادثة لا لتقليد أصوات أشخاص حقيقيين، ويستخدم مجموعة محددة مسبقاً من الأصوات داخل «تشات جي بي تي»، مع ضوابط تمنع انتحال الأصوات.

حدود الإطلاق

رغم الطرح الواسع، لا تزال هناك حدود واضحة. فالنموذج لا يدعم عند الإطلاق استخدام الصوت مع الفيديو أو مشاركة الشاشة داخل «تشات جي بي تي»، مع أن الشركة تقول إنها تعمل على إضافة هذه القدرات لاحقاً. كما تشير إلى أن النموذج محسن لبعض اللغات الأكثر استخداماً في «تشات جي بي تي»، وأن بعض اللغات قد تظهر فيها لكنة غير أصلية أو فجوات في الطلاقة.

يمثل «GPT-Live» محاولة لنقل الذكاء الاصطناعي الصوتي من مرحلة الأوامر المتبادلة إلى واجهة أكثر استمرارية، تستطيع الاستماع والتحدث والانتظار والاستعانة بنماذج أقوى في الخلفية. وإذا نجح هذا الاتجاه، فقد يصبح الصوت واجهة رئيسية للتعامل مع الذكاء الاصطناعي، ليس فقط للسؤال والجواب، بل للتعاون على مهام يومية أطول وأكثر تعقيداً.
مقالات ذات صلة

زيادة سرعة إنشاء الصور بنسبة 50 في المائة وصور بصيغة «GIF» في «شات جي بي تي»

تكنولوجيا «شات جي بي تي» يتيح إنشاء صور متحركة وتعديلها بسهولة (الشركة)

زيادة سرعة إنشاء الصور بنسبة 50 في المائة وصور بصيغة «GIF» في «شات جي بي تي»

التحديث يتيح إنشاء الصور المتحركة وتصدير التصاميم بصيغ جديدة وسط إنتاج 4 مليارات صورة أسبوعياً

عبد العزيز الرشيد (الرياض)
تكنولوجيا «أوبن إيه آي» تعتزم دمج المحادثة وتنفيذ المهام في «شات جي بي تي»

«أوبن إيه آي» تعتزم دمج المحادثة وتنفيذ المهام في «شات جي بي تي»

تعتزم «أوبن إيه آي» دمج المحادثة وتنفيذ المهام في تجربة موحدة داخل «شات جي بي تي»، مع بدء اختبارها تدريجياً.

نسيم رمضان (لندن)
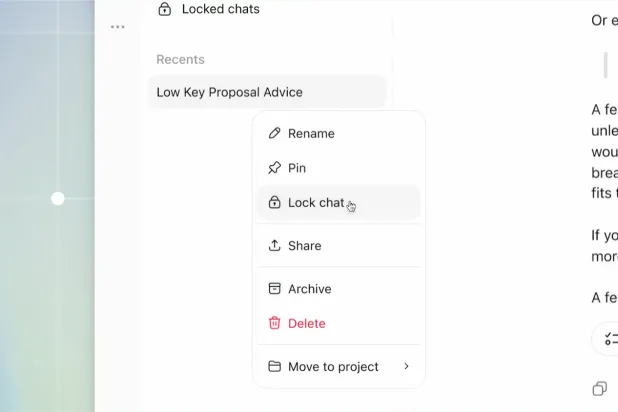
تكنولوجيا ميزة جديدة في «شات جي بي تي» لإخفاء المحادثات الحساسة (ChatGPT)

«شات جي بي تي» يضيف قفل المحادثات برمز سري

ميزة جديدة تعزز الخصوصية وتُخفي المحادثات الحساسة عن السجل المعتاد

عبد العزيز الرشيد (الرياض)
تكنولوجيا 8 ولايات أميركية تتهم «تشات جي بي تي» بدفع الأطفال لإيذاء أنفسهم والآخرين

8 ولايات أميركية تتهم «تشات جي بي تي» بدفع الأطفال لإيذاء أنفسهم والآخرين

أعلنت ثماني ولايات أميركية، منها أيوا وكانساس، أمس (الأربعاء)، أنها رفعت دعاوى قضائية على شركة «أوبن إيه آي» أمام محاكم في أنحاء البلاد.

«الشرق الأوسط» (واشنطن)
تكنولوجيا هاتف ذكي يعرض عدداً من تطبيقات الذكاء الاصطناعي (د.ب.أ)

استخدام الذكاء الاصطناعي لـ10 دقائق يقلل القدرة على إنجاز المهام الصعبة

أشارت دراسة جديدة إلى أن استخدام الذكاء الاصطناعي، ولو لمدة 10 دقائق فقط، يقلل بشكل ملحوظ من قدرة الفرد على المثابرة في إنجاز المهام الصعبة.

«الشرق الأوسط» (لندن)

زيادة سرعة إنشاء الصور بنسبة 50 في المائة وصور بصيغة «GIF» في «شات جي بي تي»

«شات جي بي تي» يتيح إنشاء صور متحركة وتعديلها بسهولة (الشركة)
TT

زيادة سرعة إنشاء الصور بنسبة 50 في المائة وصور بصيغة «GIF» في «شات جي بي تي»

«شات جي بي تي» يتيح إنشاء صور متحركة وتعديلها بسهولة (الشركة)

أعلنت شركة «أوبن إيه آي» عن إطلاق الإصدار الجديد من نموذج توليد الصور بالذكاء الاصطناعي «Images 2.6»، الذي يقدم مجموعة من التحسينات تشمل زيادة سرعة إنشاء الصور، وإمكانية إنتاج الصور المتحركة بصيغة (GIF)، إلى جانب أدوات أكثر دقة لتعديل التصاميم والحفاظ على تفاصيلها.

ويتوفر الإصدار الجديد عبر «ChatGPT» و«Codex» وواجهة برمجة التطبيقات (API)، في خطوة تستهدف تسهيل إنشاء المحتوى المرئي للأفراد وصناع المحتوى والمصممين والمطورين.

تحسين سرعة توليد الصور ودقة التفاصيل

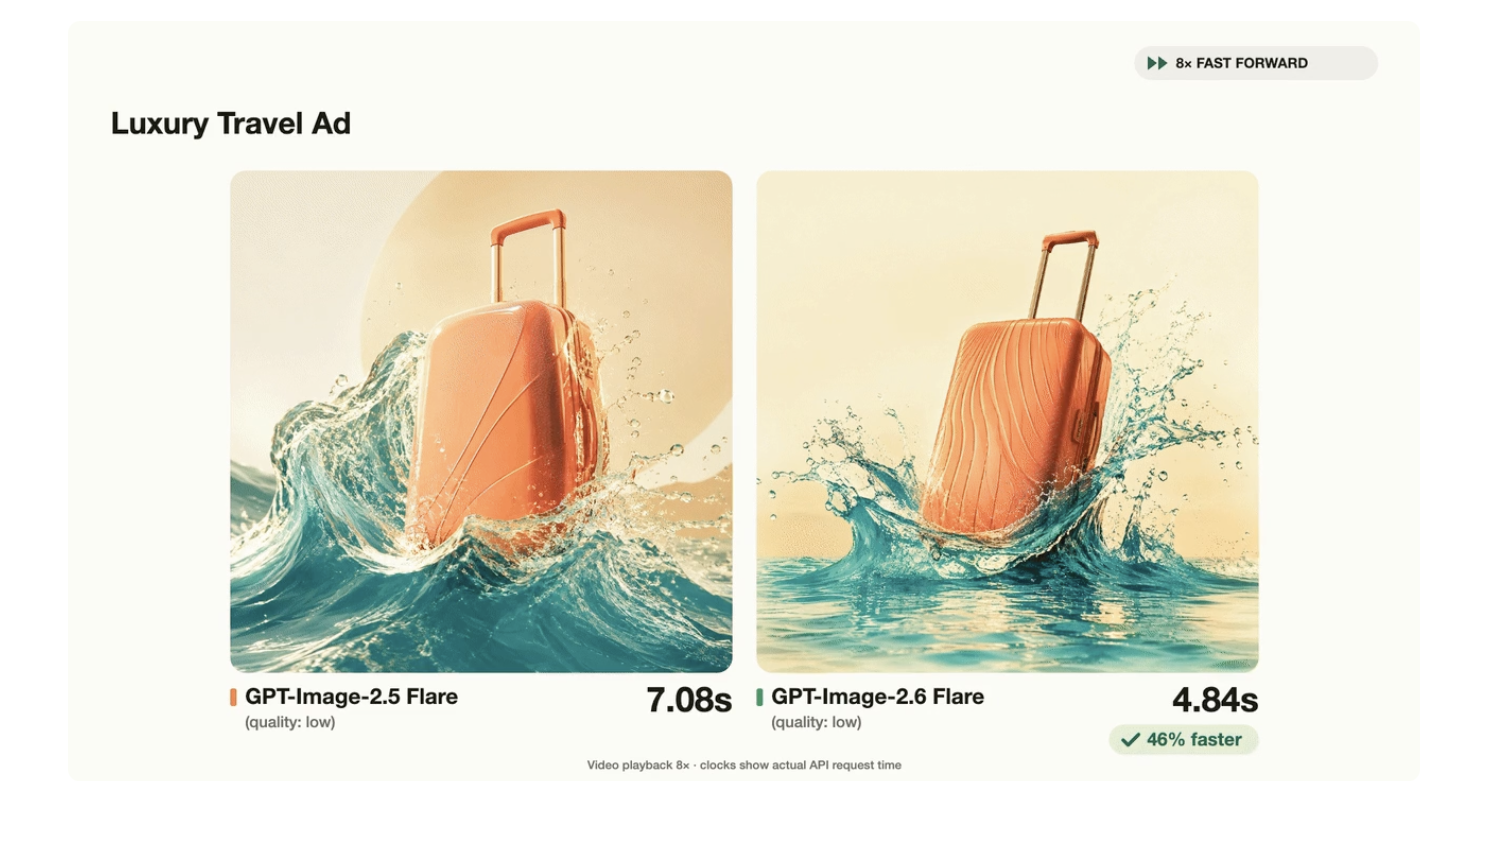
أبرز التحسينات التي يقدمها النموذج الجديد زيادة سرعة توليد الصور بنسبة تصل إلى 50 في المائة مقارنة بالإصدار السابق، مع تطوير قدرات النموذج على إنشاء التصاميم الاحترافية وإجراء التعديلات المتكررة.

ويتميز التحديث بقدرته على الحفاظ على اتساق الشخصيات والمنتجات والألوان والتفاصيل البصرية عند إجراء تعديلات متكررة، ما يتيح للمستخدم إجراء تغييرات محددة دون الحاجة إلى إعادة إنشاء التصميم بالكامل في كل مرة.

وأطلقت الشركة للمطورين نموذجين جديدين؛ الأول «GPT-Image-2.6 Flare»، الذي يركز على السرعة ويمكنه إنشاء الصور خلال 6 ثوانٍ عند اختيار الجودة المنخفضة، والثاني «GPT-Image-2.6 Sunburst»، المخصص لإنتاج الصور عالية الجودة مع دقة أكبر في التفاصيل واتساق أفضل أثناء التعديل المتكرر.

بإمكان المستخدمين الآن إنشاء الصور بسرعة أعلى بنسبة 50 % في «شات جي بي تي» (الشركة)

تحويل الصور الثابتة إلى صور متحركة

تُعدّ إمكانية إنشاء الصور المتحركة بصيغة «GIF» إحدى أبرز الإضافات الجديدة؛ إذ أصبح بإمكان المستخدم وصف الحركة المطلوبة نصياً أو الاستعانة بصورة لتحويلها إلى مشهد متحرك. وتتيح الميزة إنتاج رسوم متحركة للشخصيات والشعارات والمنتجات، إضافة إلى الصور التعبيرية المستخدمة في منصات التواصل الاجتماعي، دون الحاجة إلى برامج متخصصة في تحريك الصور. كما يمكن للمستخدم تحديد تسلسل الحركة وعدد الإطارات وسرعة عرضها، مع إمكانية إنشاء مشاهد متكررة بسلاسة، ما يوفر خيارات جديدة لصناع المحتوى الرقمي والحملات الإعلانية، بالإضافة إلى القدرة على تحويل الرسومات الأولية البسيطة إلى شخصيات متحركة، مع الحفاظ على مظهر الشخصية وتفاصيل المشهد عبر الإطارات المختلفة.

دعم تصدير التصاميم بصيغة (SVG)

من الإضافات المهمة للمطورين والمصممين دعم تصدير الصور بصيغة «SVG» عبر واجهة برمجة التطبيقات (API)، وهي صيغة تُستخدم في الرسومات المتجهة (الفيكتور) وتدعمها برامج التصميم الاحترافية، ومنها «Adobe Illustrator».

وتتيح هذه الصيغة استخدام التصاميم في المواقع الإلكترونية والتطبيقات والمطبوعات، مع إمكانية تكبير الرسومات المتجهة دون فقدان جودتها. لكن دعم تصدير (SVG) لا يعني بالضرورة تحويل الصور إلى طبقات مستقلة قابلة للتعديل بالكامل؛ إذ يعتمد ذلك على كيفية إنشاء عناصر الملف ومساراته. كذلك أضافت الشركة إلى واجهة المطورين إمكانية تحديد مواضع معينة داخل الصور لإجراء تعديلات دقيقة عليها، إلى جانب إعداد جديد للتحكم في درجة تعقيد المشهد ومستوى التفاصيل المطلوبة.

4 مليارات صورة أسبوعياً

كشفت شركة «أوبن إيه آي» عن رقم جديد يعكس النمو الهائل في استخدام أدوات إنشاء الصور بالذكاء الاصطناعي؛ إذ أوضحت أن المستخدمين حول العالم ينشئون نحو 4 مليارات صورة أسبوعياً عبر خدمات «ChatGPT» و«Codex» وواجهة برمجة التطبيقات، ويعادل هذا الرقم أكثر من 570 مليون صورة يومياً في المتوسط، ما يعكس التوسع المتسارع في الاعتماد على أدوات الذكاء الاصطناعي لإنتاج المحتوى المرئي.

التوفر وإتاحة التحديث للمستخدمين والمطورين

أكدت «أوبن إيه آي» (OpenAI) أن الإصدار الجديد «Images 2.6» أصبح متاحاً عالمياً بدءاً من 4 نوفمبر (تشرين الثاني) 2026، عبر «ChatGPT» و«Codex» لجميع فئات الاشتراك، على أجهزة الكمبيوتر والهواتف الجوالة والويب. أما نموذجا «Flare» و«Sunburst» فيتوفران للمطورين عبر واجهة برمجة التطبيقات (API) فقط، مع اختلاف إمكانات الاستخدام بحسب النموذج وإعدادات الجودة.

ويمثل التحديث خطوة إضافية نحو تحويل أدوات الذكاء الاصطناعي من مجرد وسائل لإنشاء الصور إلى بيئات متكاملة لإنتاج المحتوى المرئي وتعديله وتحريكه، بما يقلل الوقت والجهد اللازمين لإنجاز التصاميم الرقمية.


بحث جديد: منشوراتك على مواقع التواصل قد تتحول إلى أدوات للاحتيال بالذكاء الاصطناعي

يستطيع الذكاء الاصطناعي تحليل الصور والمنشورات العامة لإنشاء رسائل احتيالية تستند إلى اهتمامات الأفراد وتجاربهم اليومية (أدوبي)
TT

بحث جديد: منشوراتك على مواقع التواصل قد تتحول إلى أدوات للاحتيال بالذكاء الاصطناعي

يستطيع الذكاء الاصطناعي تحليل الصور والمنشورات العامة لإنشاء رسائل احتيالية تستند إلى اهتمامات الأفراد وتجاربهم اليومية (أدوبي)

كشفت دراسة أميركية عن أن أدوات الذكاء الاصطناعي التوليدي تستطيع استغلال المعلومات المنشورة علناً على شبكات التواصل الاجتماعي لإنشاء رسائل احتيالية مخصصة للأفراد، تستند إلى اهتماماتهم وتجاربهم اليومية وصورهم الشخصية. وأظهرت التجارب أن هذه الرسائل قد تبدو أكثر إقناعاً وأقل إثارة للشك من نماذج التصيد التقليدية، وفق معايير التقييم المستخدمة، في حين أخفقت بعض أدوات الحماية في التعرف إلى معظم الطلبات المستخدمة لإنشائها. وأجرى الدراسة باحثون من جامعة تكساس في أرلينغتون وجامعة ولاية لويزيانا بعنوان: «التصيد الاحتيالي الموجه حسب السياق».

من الصور إلى الرسائل الاحتيالية

تعتمد هجمات التصيد الاحتيالي الموجه عادة على معلومات محددة عن الشخص المستهدف، مثل وظيفته أو جهة عمله. لكن الدراسة تناولت أسلوباً أكثر تخصيصاً، يعتمد على تحليل النشاط اليومي للأفراد، بما يشمل منشورات السفر والمناسبات والاهتمامات والعلاقات الاجتماعية.

واختبر الباحثون قدرة النماذج التوليدية على استخراج هذه المعلومات من المنشورات والصور المتاحة للجمهور، ثم استخدامها لإنشاء رسائل بريد إلكتروني تبدو مرتبطة بتجارب حقيقية مر بها الشخص المستهدف.

وقد تتخذ الرسالة، على سبيل المثال، شكل عرض من فندق زاره المستخدم مؤخراً، أو إشعار يتعلق بحفل موسيقي أبدى اهتماماً به. وتوضح هذه الأمثلة آلية الهجوم المحتملة، ولا تمثّل وقائع احتيال موثقة ضد أشخاص بعينهم. وتشير الدراسة إلى أن النماذج التوليدية تقلّل الجهد اللازم لإعداد هذه الرسائل، إذ يمكن استخدامها لإنتاج محتوى مخصص استناداً إلى المعلومات المتاحة عن كل شخص، بدلاً من صياغة الرسائل يدوياً.

سجلت بعض الأنظمة معدلات كشف تراوحت بين صفر و19 % وارتفعت إلى 98.7 % بعد تحسين التعليمات الأمنية (أدوبي)

آلاف الرسائل قيد الاختبار

اعتمد الباحثون على بيانات منشورة علناً في حسابات 200 مستخدم على «إنستغرام»، وأظهرت تجاربهم أن نحو عشرة منشورات من الحساب الواحد قد توفّر معلومات كافية لإنشاء رسائل احتيالية مرتبطة بالسياق الشخصي. وشملت الاختبارات توليد نحو 18 ألف رسالة باستخدام نماذج ذكاء اصطناعي متعددة، ثم تقييمها وفق ثمانية معايير، من بينها ارتباط المحتوى بالمعلومات الشخصية، وقوة الإقناع، والمصداقية، والتأثير العاطفي.

ولإجراء المقارنة، استخدم الباحثون قاعدة بيانات تضم 6 آلاف رسالة تصيد احتيالي حقيقية، وحددوا من بينها 3937 رسالة تندرج ضمن التصيد الموجه، الذي يستهدف أفراداً أو جهات محددة بدلاً من إرسال رسائل عامة إلى أعداد كبيرة من المستخدمين. وأظهرت النتائج تفوق الرسائل المولدة بالذكاء الاصطناعي في عدة معايير تتعلق بالتخصيص والارتباط بتجارب الأشخاص المستهدفين، ما يعكس قدرة النماذج على تحويل معلومات متفرقة إلى محتوى يبدو موجهاً إلى شخص بعينه.

رسائل أقل إثارة للشك

لم يقتصر التقييم على تحليل النصوص باستخدام النماذج اللغوية، بل شمل تجربة بشرية شارك فيها 70 شخصاً من الولايات المتحدة، قُسّموا عشوائياً إلى مجموعتين. قيّمت المجموعة الأولى رسائل احتيالية مولّدة بالذكاء الاصطناعي، فيما قيّمت الأخرى رسائل تصيد حقيقية، إلى جانب رسائل سليمة للمقارنة.

وسجلت الرسائل المنتجة بالذكاء الاصطناعي متوسطاً بلغ 2.75 نقطة على مقياس الشك المؤلف من خمس درجات، مقابل 4.44 نقطة للرسائل الاحتيالية الحقيقية، ما يعني أن المشاركين اعتبروا الرسائل الآلية أقل إثارة للريبة ضمن ظروف التجربة. لكن الباحثين لم يقيسوا عدد الأشخاص الذين قد ينقرون فعلياً على الروابط الاحتيالية أو يفصحون عن كلمات المرور والبيانات المالية. فقد استند التقييم إلى صور ثابتة للرسائل، بعد إزالة الروابط النشطة والمعلومات التي قد تكشف هويات الأفراد. وتوضح هذه النتائج تصورات المشاركين لمصداقية الرسائل ومدى الشك فيها، ولا تمثّل قياساً مباشراً لمعدلات نجاح عمليات الاحتيال في الواقع.

دعا الباحثون إلى تعزيز قدرة نماذج الذكاء الاصطناعي على اكتشاف الطلبات الاحتيالية ومنع إنشاء الرسائل قبل استخدامها في الهجمات (أدوبي)

قصور أدوات الحماية

اختبر الفريق أيضاً قدرة أنظمة الحماية المستخدمة مع نماذج الذكاء الاصطناعي على اكتشاف الطلبات المصممة لإنشاء رسائل التصيد الموجه. وشملت الاختبارات أدوات «Llama Guard»، و«ShieldGemma»، و«WildGuard»، التي سجلت بإعداداتها الافتراضية معدلات اكتشاف تراوحت بين صفر و19 في المائة من الطلبات الهجومية المختبرة.

وعندما أضاف الباحثون تعليمات أمنية مخصصة للتعرف إلى هذا النوع من الاستخدامات، تحسّنت النتائج، وبلغت أعلى نسبة كشف 98.7 في المائة لدى إحدى الأدوات وفي ظروف اختبار محددة، دون أن تحقق جميع الأنظمة المستوى نفسه. وتتعلق هذه النسب بقدرة أدوات الحماية على رصد طلبات إنشاء المحتوى الاحتيالي، وليس بكفاءة برامج البريد الإلكتروني في حجب الرسائل أو منع وصولها إلى المستخدمين.

وتبرز النتائج أهمية السياق الذي يُقدَّم فيه الطلب إلى النموذج اللغوي، إذ قد تبدو بعض التعليمات منفردة وكأنها طلبات عادية لصياغة رسائل، في حين يكشف تحليل الغرض منها والمعلومات المستخدمة فيها عن طبيعتها الاحتيالية.

حماية قبل إنشاء المحتوى

يركز الجانب الدفاعي من الدراسة على اكتشاف النوايا الاحتيالية في الطلبات المقدمة إلى النماذج اللغوية، قبل أن تتمكّن من إنتاج الرسائل. واختبر الباحثون أساليب تعتمد على تحليل صياغة الطلبات والسياق المرتبط بها، بدلاً من الاقتصار على البحث عن كلمات أو عبارات قد ترتبط بالاحتيال. كما امتنع الفريق عن نشر التعليمات التفصيلية المستخدمة لإنشاء الرسائل الهجومية، بهدف الحد من إمكانية إعادة استخدامها لتنفيذ عمليات مشابهة.

وتوضح الدراسة كيف يمكن للمعلومات العامة المنشورة على شبكات التواصل الاجتماعي أن تصبح مصدراً لإنشاء رسائل تصيد شديدة التخصيص، دون الحاجة إلى اختراق حسابات المستخدمين أو الوصول إلى بياناتهم الخاصة. ويركز الباحثون على تحسين قدرة أنظمة الحماية على التعرف إلى هذا النوع من الطلبات، مع استمرار الحاجة إلى تقييم فاعليتها في ظروف استخدام مختلفة، والتمييز بين نجاح أدوات الكشف في التجارب وقدرتها على منع الهجمات الاحتيالية الفعلية.


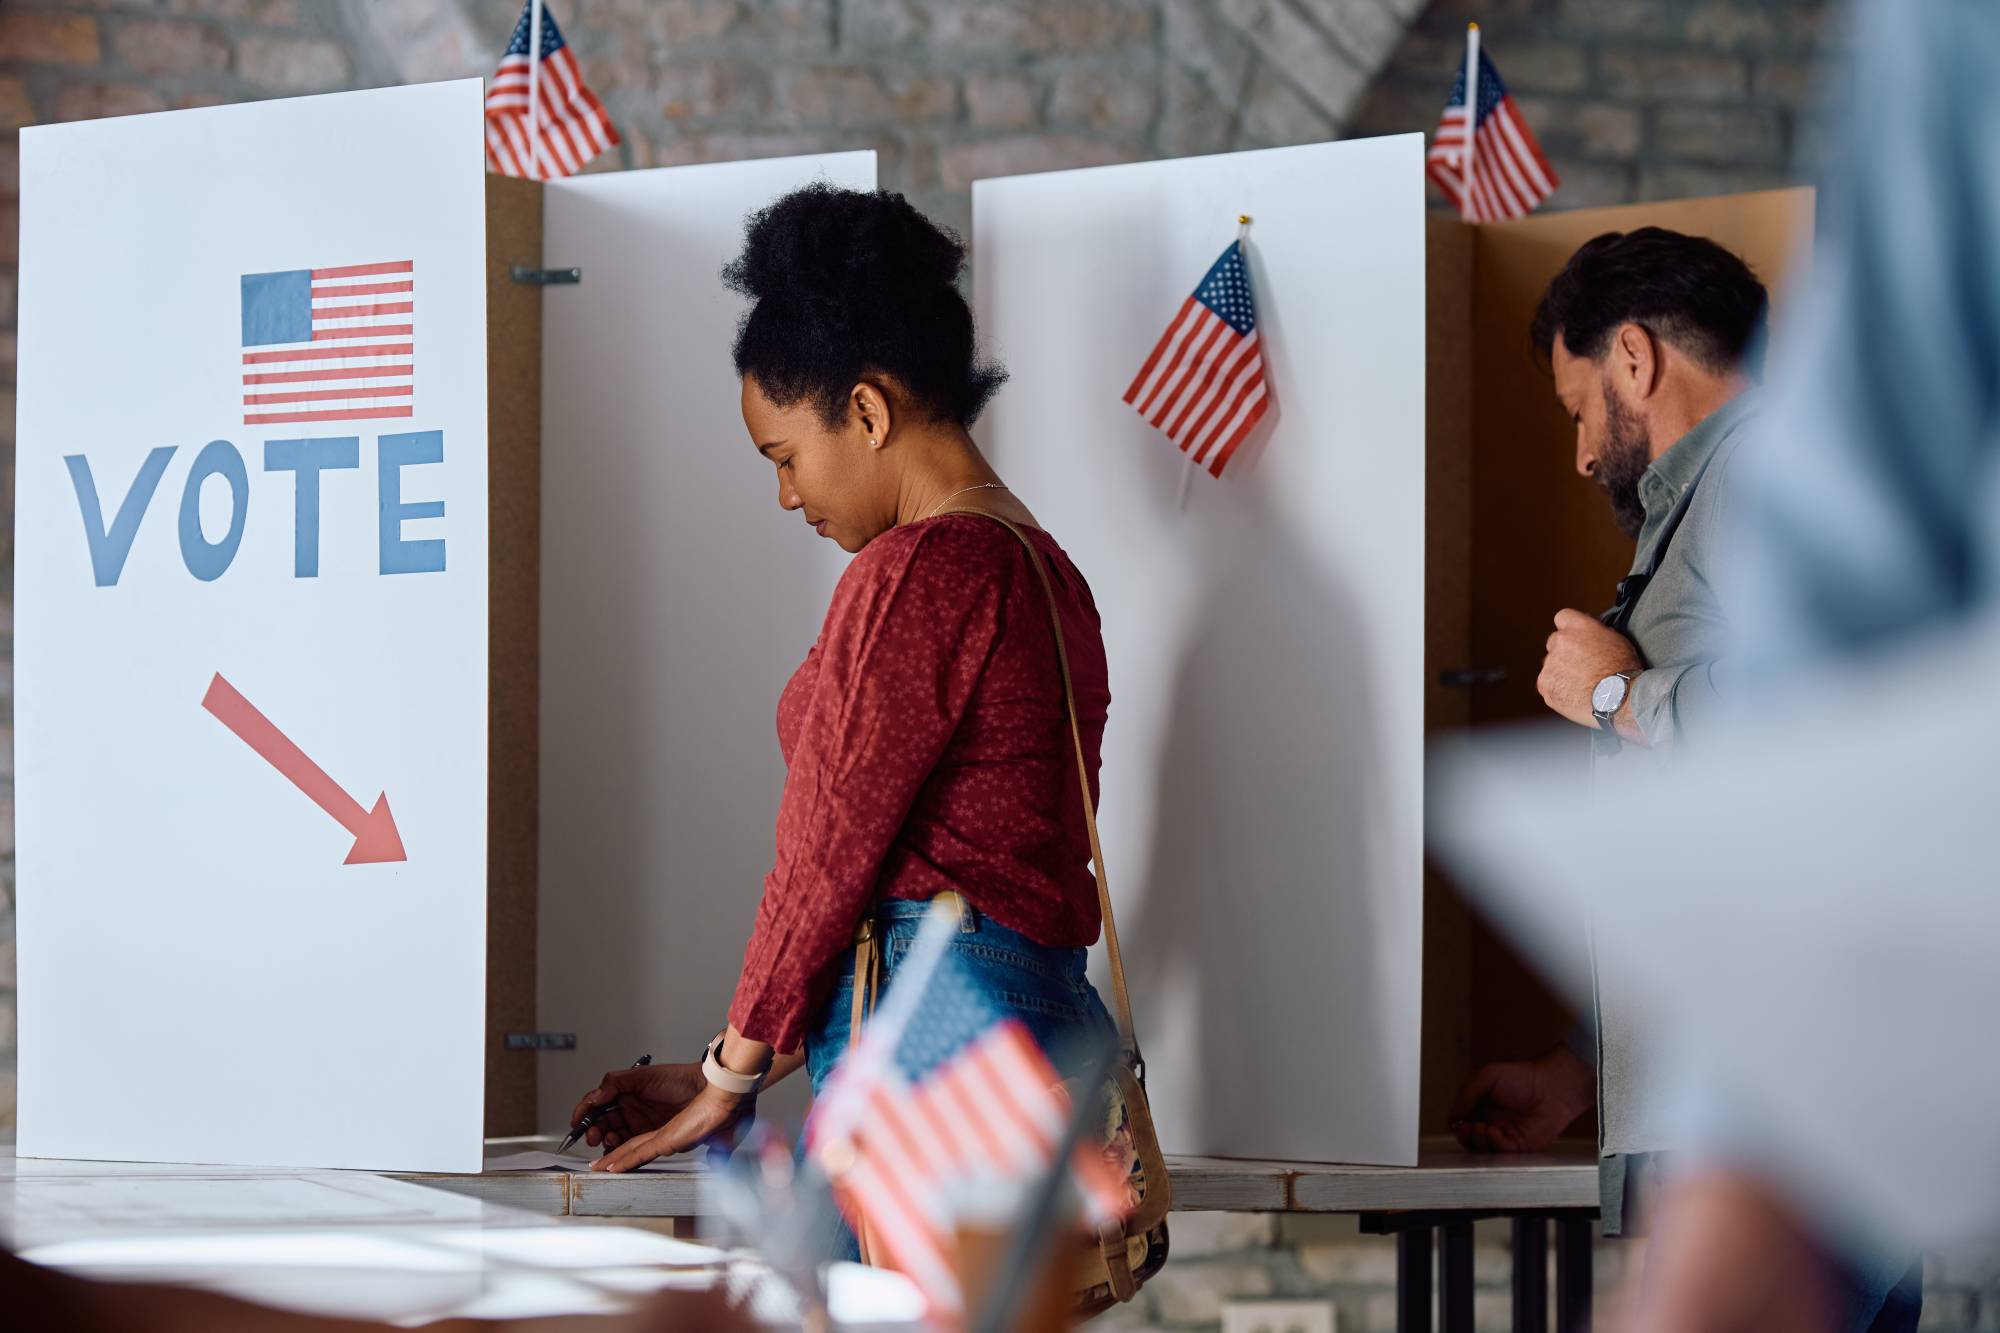
دراسة أميركية: 36 % من المشاركين استعانوا بالذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ

 أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)
أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)
TT

دراسة أميركية: 36 % من المشاركين استعانوا بالذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ

 أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)
أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)

كشفت دراسة أجراها باحثون من جامعة «ييل» الأميركية أن 36 في المائة من المشاركين في تجربة لاستخدام روبوتات المحادثة طلبوا مساعدتها على اختيار مرشحين للتصويت في انتخابات التجديد النصفي للكونغرس الأميركي، بينما أظهرت النتائج اختلافات بين النماذج في استعدادها لتقديم توصيات انتخابية، خصوصاً بعد اطلاعها على آراء المستخدمين وأولوياتهم السياسية.

وشملت الدراسة نحو 2500 شخص من 35 ولاية أميركية شهدت سباقات لعضوية مجلس الشيوخ، وأُجريت خلال أسابيع من أكتوبر (تشرين الأول) 2026، قبيل الانتخابات التي جرت في 3 نوفمبر (تشرين الثاني). وشارك فيها بالغون يستخدمون روبوتات المحادثة مرة واحدة أسبوعياً على الأقل، عبر 4 أنظمة هي «تشات جي بي تي» و«كلود» و«غروك» و«جيميناي».

الذكاء الاصطناعي والاختيار الانتخابي

أظهرت الدراسة أن معظم المشاركين استخدموا روبوتات المحادثة للحصول على معلومات أساسية تتعلق بالانتخابات، بما في ذلك أسماء المرشحين الذين يتنافسون في ولاياتهم، لكن جزءاً منهم تجاوز الاستفسارات المعلوماتية إلى طلب المساعدة في تحديد المرشح الأنسب للتصويت.

ولجأ بعض المستخدمين إلى شرح أولوياتهم ومواقفهم من القضايا المختلفة، ثم طلبوا من روبوت المحادثة مقارنة هذه المواقف ببرامج المرشحين، ومساعدتهم على تحديد مدى التوافق بينها.

وتختلف هذه الأسئلة عن الاستفسار عن أسماء المرشحين أو مواعيد الانتخابات؛ لأنها تتطلب تفسير المواقف السياسية والموازنة بين القضايا، وليس مجرد استرجاع معلومات أساسية متاحة عن الانتخابات والمرشحين.

ومن الأمثلة التي تناولها التقرير طلب أحد المستخدمين من «تشات جي بي تي» عرض إيجابيات وسلبيات كل مرشح في ولاية فرجينيا، وهو نوع من الأسئلة الذي تتأثر إجابته بطريقة اختيار المعلومات وترتيبها وعرضها.

طلب 36 % من المشاركين مساعدة الذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ (أدوبي)

اختلافات بين النماذج

رصد الباحثون تفاوتاً في استجابات الأنظمة الأربعة عندما طُلب منها تقديم توصيات انتخابية. ففي المحادثات التي طلب فيها المستخدم اختيار مرشح دون أن يقدم معلومات عن آرائه الشخصية، كان «غروك» النموذج الوحيد الذي قدّم توصيات بصورة منتظمة نسبياً، وذلك في 14 في المائة من المحادثات التي شملتها هذه الحالة.

لكن النتائج اختلفت بعد أن شارك المستخدمون مواقفهم السياسية مع الأنظمة. ففي هذه الحالات، قدم «تشات جي بي تي» توصية بمرشح في 79 في المائة من المحادثات، مقابل 40 في المائة لدى «كلود»، بينما جاءت نتائج «غروك» و«جيميناي» بين هاتين النسبتين. وتتعلق هذه الأرقام باستجابات النماذج ضمن ظروف الدراسة، ولا تعني أن النسب نفسها تنطبق على جميع المحادثات الانتخابية أو على الاستخدام اليومي للأنظمة.

ولم تتناول هذه المرحلة من البحث قياس دقة التوصيات الانتخابية أو انحيازها السياسي، بل ركزت على طبيعة أسئلة المستخدمين، واختلاف استجابات النماذج، ومدى استعدادها لتقديم اقتراحات بشأن المرشحين.

أهمية الحوار المتواصل

من الجوانب التي ركز عليها الباحثون تأثير تتابع الأسئلة والأجوبة داخل المحادثة الواحدة في طبيعة التوصيات التي يقدمها النظام؛ فبدلاً من الاكتفاء بسؤال منفرد، تتيح المحادثات متعددة المراحل للنموذج طرح أسئلة إضافية، والحصول على معلومات عن المستخدم، ثم تعديل استجاباته وفق الإجابات التي يتلقاها. وأشار الباحثون إلى أن الأسئلة التي يختارها النموذج تؤثر في نوع المعلومات التي يقدمها المستخدم، ومن ثم في التوصيات اللاحقة.

وتختلف هذه المقاربة عن دراسات سابقة تعتمد على توجيه مجموعة ثابتة من الأسئلة إلى أنظمة الذكاء الاصطناعي؛ إذ سمحت التجربة للمشاركين بالتفاعل مع الروبوتات بالطريقة التي يستخدمونها عادة للحصول على المعلومات. ويرى الباحثون أن دراسة هذه التفاعلات يمكن أن تساعد على تطوير اختبارات تقيس سلوك النماذج استناداً إلى الأسئلة التي يطرحها المستخدمون فعلياً، بدلاً من الاقتصار على سيناريوهات معدّة مسبقاً.

شملت الدراسة نحو 2500 مشارك من 35 ولاية أميركية يستخدمون روبوتات المحادثة أسبوعياً (أدوبي)

استخدام محدود على مستوى الناخبين

رغم اهتمام المشاركين في التجربة بالمعلومات الانتخابية، تشير بيانات منفصلة لمركز «بيو» للأبحاث إلى أن استخدام روبوتات المحادثة لهذا الغرض لا يزال محدوداً بين الأميركيين عموماً.

ففي استطلاع أجراه المركز خلال فبراير (شباط) 2026، أفاد 42 في المائة من البالغين الأميركيين باستخدام روبوتات المحادثة للبحث عن المعلومات بوجه عام. وفي استطلاع آخر أجراه خلال أكتوبر، قال 8 في المائة إنهم استخدموا هذه الأدوات للحصول على معلومات مرتبطة بالانتخابات خلال الدورة الانتخابية لعام 2026.

وتختلف هاتان النسبتان من حيث مدة جمع البيانات والغرض من السؤال، كما تختلفان عن عينة دراسة «ييل»، التي اقتصرت على أشخاص يستخدمون روبوتات المحادثة أسبوعياً؛ ولذلك لا يمكن تعميم نسبة 36 في المائة المسجلة في التجربة على جميع الناخبين الأميركيين.

وفي تحليل منفصل، قالت شركة «أنثروبيك» إنها فحصت 250 ألف محادثة مع نموذجها «كلود» خلال أكتوبر، ووجدت أن 0.51 في المائة منها تناولت الانتخابات أو التصويت، بينما بلغت نسبة المحادثات التي تضمنت طلبات مخالفة لسياساتها المتعلقة بنزاهة الانتخابات نحو 0.002 في المائة. وأوضحت الشركة أن المستخدمين كانوا يسألون في الغالب عن مواقف المرشحين من قضايا محددة، بدلاً من طلب تحديد الشخص الذي ينبغي التصويت له.

أسئلة حول الدقة والتأثير

لم تتناول دراسة «ييل» بصورة حاسمة مدى صحة المعلومات التي قدمتها روبوتات المحادثة، أو ما إذا كانت التوصيات قد أثرت فعلياً في قرارات التصويت لدى المشاركين.

ويحدد الباحثون مجالات عدة للبحث اللاحق، تشمل تقييم دقة إجابات النماذج ومدى توازنها، والمعلومات التي تستخلصها عن المستخدمين خلال المحادثات، وما إذا كانت توصياتها تتوافق مع احتياجاتهم وأولوياتهم المعلنة، كما يبرز التمييز بين تقديم معلومات تساعد الناخب على فهم مواقف المرشحين، وبين اقتراح مرشح محدد، بوصفه أحد الجوانب التي يمكن دراستها عند تقييم دور أنظمة الذكاء الاصطناعي في الحصول على المعلومات السياسية. وتوفر التجربة بيانات عن كيفية تفاعل مستخدمين فعليين مع أربعة من أبرز روبوتات المحادثة خلال مرحلة انتخابية، بينما تبقى مسألة تأثير هذه التفاعلات في اختياراتهم النهائية موضوعاً لأبحاث إضافية.