كيف يؤثر الذكاء الاصطناعي على عقل الإنسان؟

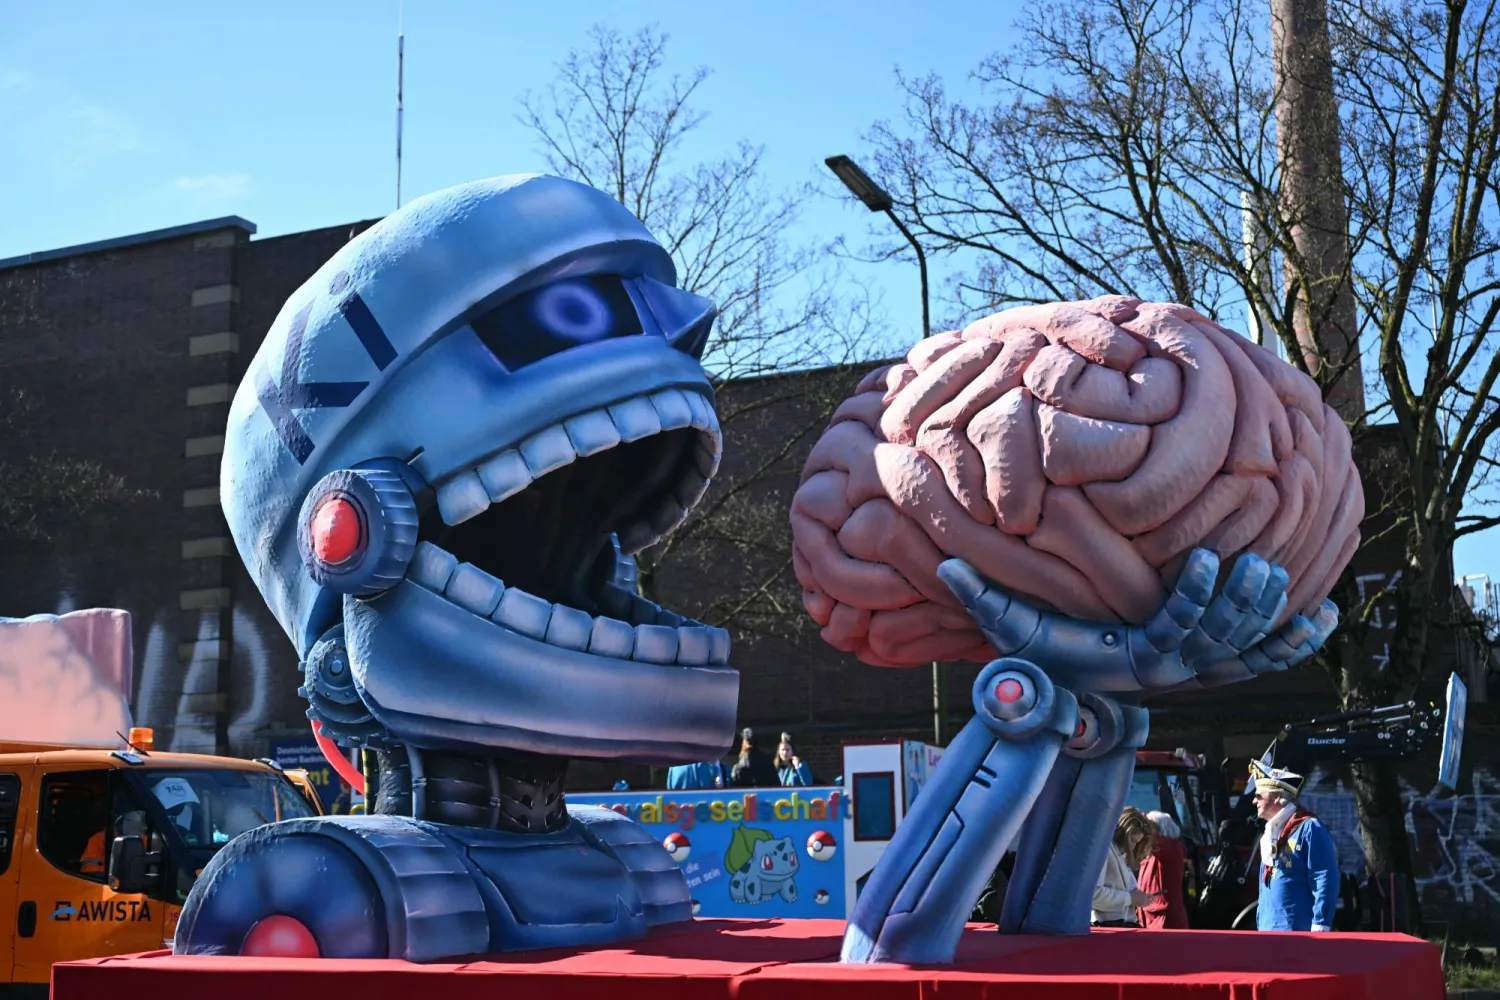
قد لا يستبدلنا الذكاء الاصطناعي مباشرة لكنه قد يجعلنا نعطّل أدمغتنا عن العمل إذا اتكلنا عليه كثيراً (أ.ف.ب)
TT

كيف يؤثر الذكاء الاصطناعي على عقل الإنسان؟

قد لا يستبدلنا الذكاء الاصطناعي مباشرة لكنه قد يجعلنا نعطّل أدمغتنا عن العمل إذا اتكلنا عليه كثيراً (أ.ف.ب)

شَهد العالم في السنوات الأخيرة انتشاراً متسارعاً لتطبيقات الذكاء الاصطناعي، ما أثار تساؤلات حول تأثيره على القدرات الذهنية للبشر. يرى بعض الخبراء أن الخطر الحقيقي للذكاء الاصطناعي ليس في أنه سيستولي على وظائفنا، بل في احتمال أن نعتمد عليه، لدرجة تضمر معها مهاراتنا العقلية. بعبارة أخرى، قد لا يستبدلنا الذكاء الاصطناعي مباشرة، لكنه قد يجعلنا نعطّل أدمغتنا عن العمل إذا اتكلنا عليه كثيراً.

هل يُقلل الذكاء الاصطناعي من اعتماد الإنسان على التفكير؟

تراجع التفكير النقدي بسبب الاعتماد المفرط

يُحذّر باحثون من أن الإفراط في استخدام أدوات الذكاء الاصطناعي قد يُقلل اعتماد الإنسان على التفكير النقدي وحل المشكلات بنفسه. ووجدت دراسة حديثة أجرتها شركة «مايكروسوفت» وجامعة كارنيغي ميلون الأميركية، أن الموظفين الذين وثّقوا بدقة مساعدات الذكاء الاصطناعي في العمل بدأوا يفكرون بشكل أقل نقدياً في نتائج الدراسة، وكلما زاد اطمئنان الشخص إلى قدرة الأداة الذكية، قلَّ تدخله العقلي في مراجعة ما تقدمه من حلول، ما يُنذر بخطر «ضمور» مهارات التفكير المستقل على المدى البعيد، وفق موقع «لايف ساينس» العلمي.

يحذّر باحثون من أن الإفراط في استخدام أدوات الذكاء الاصطناعي قد يقلل من اعتماد الإنسان على التفكير النقدي (أ.ف.ب)

الذكاء الاصطناعي بوصفه امتداداً للعقل وليس بديلاً عنه

مع ذلك، يُشير بعض الخبراء إلى أن أتمتة المهام الذهنية الروتينية باستخدام التقنيات ليست أمراً جديداً تماماً، بل قد يكون مفيداً إذا استُخدم بحكمة، فالاستعانة بوسائل خارجية لتخزين المعلومات وتذكّرها ممارسة قديمة (مثل تدوين الملاحظات) مكّنت البشر من التركيز على مهام أكثر تعقيداً.

وينطبق الأمر نفسه على أدوات الذكاء الاصطناعي الحديثة، إذ يُمكن لهذه التقنيات أن تعمل بوصفها امتداداً للعقل البشري يُساعده في جمع المعلومات، وتذكُّر التفاصيل التي قد يغفلها الإنسان، ومن ثم تحرير الذهن لأداء مهام فكرية أعلى، وفق مجلة «وايرد» الأميركية المعنية بقضايا التكنولوجيا.

هل يؤدي استخدام الذكاء الاصطناعي إلى الكسل العقلي؟

التأثير على المهارات اللغوية والإبداعية

يُحذّر متخصصون في علم النفس والتربية من أن الاعتماد المستمر على الذكاء الاصطناعي قد يؤدي إلى نوع من «الكسل العقلي» أو التراخي الذهني؛ إذ يميل البعض إلى ترك المهمة الفكرية للآلة بالكامل، ما يُقلل من جهدهم الشخصي في التفكير والتعلّم. على سبيل المثال، ذكر أحد الصحافيين أنه اعتمد على «شات جي بي تي» لصياغة رسائل بالبريد الإلكتروني بلغة أجنبية، ولاحظ مع الوقت تراجُع قدرته على التعبير بنفسه بتلك اللغة. وقد علّق عالم النفس روبرت ستيرنبرغ محذراً: «إذا لم تستخدم قدرتك على الإبداع فستبدأ هذه القدرة في التلاشي».

الاعتماد المستمر على الذكاء الاصطناعي قد يؤدي إلى نوع من «الكسل العقلي» (رويترز)

التراجع في القدرات والمهارات لدى الطلاب

وبالمثل، تُشير لويزا دهماني، عالمة الأعصاب في مستشفى ماساتشوستس العام في الولايات المتحدة، إلى أن أدوات مثل أنظمة الملاحة «دي بي إس» والنماذج اللغوية الذكية «تجعلنا كسالى إدراكياً»، موضحةً أنه رغم إمكانية استخدامها بوعي، فإن أغلب الناس سيسلكون الطريق الأسهل، ويدعون الجهاز يفكر عنهم، وفق ما نقله موقع «فيوتشوريزم» المهتم بالتكنولوجيا.

في السياق نفسه، ينبّه خبراء التربية إلى أن استخدام الذكاء الاصطناعي بوصفه حلّاً فورياً للمهمات الصعبة قد يحرم الطلاب من تطوير مهاراتهم الذهنية على المدى الطويل. فقد وجد الباحثون أن الطلاب الذين يلجأون باستمرار إلى أدوات مثل «شات جي بي تي» لإنجاز واجباتهم يظهرون اعتماداً مفرطاً عليها وتراجعاً تدريجياً في مهارات التفكير والتحصيل الدراسي، مقارنةً بمن يؤدون مهامهم بأنفسهم. ويُحذّر المختصون من أن الاتكال على الذكاء الاصطناعي بديلاً للعمل الذهني -بدلاً من كونه مكملاً له- قد يصعّب على الطالب لاحقاً التعامل مع التحديات المعقدة بشكل مستقل، وفق شبكة «يورونيوز».

ما أثر الاستعمال المستمر للذكاء الاصطناعي على الذاكرة والانتباه؟

تأثير الذكاء الاصطناعي على الذاكرة البشرية

للذكاء الاصطناعي قدرةٌ على دعم الذاكرة البشرية بطرق إيجابية؛ فهو يُساعدنا على تسجيل المواعيد والمهام، وتذكّر المعلومات بسهولة، مثلما تفعل تطبيقات التقويم والمذكّرات في الهواتف الذكية، وفق مجلة «وايرد».

من ناحية أخرى، يُحذّر بعض علماء الأعصاب من أن إهمال تمرين الذاكرة والاعتماد الدائم على الأجهزة قد يضعف قدرتنا على التذكّر مع مرور الوقت. يقول البروفسور أوليفر هاردت، من جامعة مكغيل الكندية: «بمجرد أن تتوقف عن استخدام ذاكرتك، فإنها ستزداد سوءاً»، مشدداً على أن الراحة والسهولة «لهما ثمن»، وأن القيام ببعض المهام ذهنياً دون مساعدة، يعدّ تمريناً مفيداً للدماغ. ويشير هاردت إلى أن مَن يعتمد على نظام الملاحة «جي بي إس» لفترات طويلة قد يُعاني من تراجع في مهارات التذكّر المكاني لديه بمرور الوقت، حسبما أفاد تقرير لصحيفة «الغارديان» البريطانية.

للذكاء الاصطناعي قدرة على دعم الذاكرة البشرية بطرق إيجابية فهو يساعدنا على تسجيل المواعيد والمهام وتذكّر المعلومات (أ.ف.ب)

كيف يؤثر الذكاء الاصطناعي على التركيز والانتباه؟

بالنسبة للانتباه، تؤدي التقنيات الرقمية الحديثة -ومنها تطبيقات الذكاء الاصطناعي- إلى تشتّت التركيز وضعف القدرة على الانتباه، وذلك بسبب التنبيهات المستمرة وسهولة التنقل بين المهام والمحتويات. وقد وجدت أبحاث علمية أن متوسط مدة التركيز لدى الفرد انخفض من نحو دقيقتين ونصف الدقيقة قبل عقدين، إلى أقل من دقيقة في السنوات الأخيرة، وفق تقرير آخر ﻟ«الغارديان».

ولا شك في أن هذا التراجع في التركيز يؤثر سلباً على الذاكرة أيضاً، لأن تكوين ذكريات متينة يتطلّب قدراً كافياً من الانتباه أثناء التعلّم أو وقوع الأحداث. من هنا، فإن الاعتماد المفرط على الأجهزة لتذكيرنا بكل شيء، وتقسيم انتباهنا باستمرار بين عدة مهام، قد يُضعف قدرتنا على ترسيخ المعلومات في الذاكرة طويلة المدى.


مقالات ذات صلة

دراسة أميركية: 36 % من المشاركين استعانوا بالذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ

تكنولوجيا  أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)

دراسة أميركية: 36 % من المشاركين استعانوا بالذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ

الدراسة بيّنت أن 36 في المائة من المشاركين طلبوا مساعدة روبوتات الذكاء الاصطناعي لاختيار مرشحيهم مع تفاوت استجابات النماذج.

نسيم رمضان (لندن)
الاقتصاد ورقة نقدية بريطانية من فئة 5 جنيهات إسترلينية تحمل صورة ونستون تشرشل (رويترز)

الإسترليني يتراجع أمام الدولار ويتمسك بأعلى مستوياته في 19 شهراً أمام اليورو

تراجع الجنيه الإسترليني أمام الدولار، يوم الجمعة، في ظل موجة بيع واسعة في أسواق الأسهم ضغطت على العملات الأكثر ارتباطاً بالنمو الاقتصادي العالمي.

«الشرق الأوسط» (لندن)
الاقتصاد شعار «أنثروبيك» في سان فرانسيسكو بكاليفورنيا (رويترز)

مستثمرون: الاتجاه الحالي ربما يهدد توقيت طرح «أنثروبيك»

أبدى مستثمرون محتملون في الاكتتاب العام الأولي المرتقب لشركة «أنثروبيك» شكوكاً حول قدرة شركة الذكاء الاصطناعي الناشئة على المضي قدماً في جولتها الترويجية.

«الشرق الأوسط» (نيويورك)
تكنولوجيا أظهرت النماذج اللغوية قدرة على إنتاج أنماط كتابة تعكس سمات شخصية بشرية دون أن يثبت ذلك امتلاكها شخصية فعلية (غيتي)

هل يمتلك الذكاء الاصطناعي شخصية؟

أظهرت دراسة ألمانية تفوّق البشر في تمييز النصوص الآلية رغم قدرة نماذج الذكاء الاصطناعي على محاكاة سمات الشخصية البشرية واستنتاجها.

نسيم رمضان (لندن)
الاقتصاد ورقة نقدية من الروبية الهندية في صورة توضيحية (رويترز)

السندات الهندية تتفوق آسيوياً... والروبية تبلغ أعلى مستوى في 6 أشهر

تصدرت السندات الحكومية الهندية أداء الأسواق الناشئة في آسيا خلال الأسبوع الحالي، فيما استعادت الروبية جاذبيتها بين عملات الأسواق الناشئة.

«الشرق الأوسط» (مومباي)

دراسة أميركية: 36 % من المشاركين استعانوا بالذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ

 أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)
أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)
TT

دراسة أميركية: 36 % من المشاركين استعانوا بالذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ

 أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)
أظهرت الدراسة تفاوتاً بين 4 نماذج لغوية في استعدادها لتقديم توصيات انتخابية للمستخدمين (أدوبي)

كشفت دراسة أجراها باحثون من جامعة «ييل» الأميركية أن 36 في المائة من المشاركين في تجربة لاستخدام روبوتات المحادثة طلبوا مساعدتها على اختيار مرشحين للتصويت في انتخابات التجديد النصفي للكونغرس الأميركي، بينما أظهرت النتائج اختلافات بين النماذج في استعدادها لتقديم توصيات انتخابية، خصوصاً بعد اطلاعها على آراء المستخدمين وأولوياتهم السياسية.

وشملت الدراسة نحو 2500 شخص من 35 ولاية أميركية شهدت سباقات لعضوية مجلس الشيوخ، وأُجريت خلال أسابيع من أكتوبر (تشرين الأول) 2026، قبيل الانتخابات التي جرت في 3 نوفمبر (تشرين الثاني). وشارك فيها بالغون يستخدمون روبوتات المحادثة مرة واحدة أسبوعياً على الأقل، عبر 4 أنظمة هي «تشات جي بي تي» و«كلود» و«غروك» و«جيميناي».

الذكاء الاصطناعي والاختيار الانتخابي

أظهرت الدراسة أن معظم المشاركين استخدموا روبوتات المحادثة للحصول على معلومات أساسية تتعلق بالانتخابات، بما في ذلك أسماء المرشحين الذين يتنافسون في ولاياتهم، لكن جزءاً منهم تجاوز الاستفسارات المعلوماتية إلى طلب المساعدة في تحديد المرشح الأنسب للتصويت.

ولجأ بعض المستخدمين إلى شرح أولوياتهم ومواقفهم من القضايا المختلفة، ثم طلبوا من روبوت المحادثة مقارنة هذه المواقف ببرامج المرشحين، ومساعدتهم على تحديد مدى التوافق بينها.

وتختلف هذه الأسئلة عن الاستفسار عن أسماء المرشحين أو مواعيد الانتخابات؛ لأنها تتطلب تفسير المواقف السياسية والموازنة بين القضايا، وليس مجرد استرجاع معلومات أساسية متاحة عن الانتخابات والمرشحين.

ومن الأمثلة التي تناولها التقرير طلب أحد المستخدمين من «تشات جي بي تي» عرض إيجابيات وسلبيات كل مرشح في ولاية فرجينيا، وهو نوع من الأسئلة الذي تتأثر إجابته بطريقة اختيار المعلومات وترتيبها وعرضها.

طلب 36 % من المشاركين مساعدة الذكاء الاصطناعي لاختيار مرشحي مجلس الشيوخ (أدوبي)

اختلافات بين النماذج

رصد الباحثون تفاوتاً في استجابات الأنظمة الأربعة عندما طُلب منها تقديم توصيات انتخابية. ففي المحادثات التي طلب فيها المستخدم اختيار مرشح دون أن يقدم معلومات عن آرائه الشخصية، كان «غروك» النموذج الوحيد الذي قدّم توصيات بصورة منتظمة نسبياً، وذلك في 14 في المائة من المحادثات التي شملتها هذه الحالة.

لكن النتائج اختلفت بعد أن شارك المستخدمون مواقفهم السياسية مع الأنظمة. ففي هذه الحالات، قدم «تشات جي بي تي» توصية بمرشح في 79 في المائة من المحادثات، مقابل 40 في المائة لدى «كلود»، بينما جاءت نتائج «غروك» و«جيميناي» بين هاتين النسبتين. وتتعلق هذه الأرقام باستجابات النماذج ضمن ظروف الدراسة، ولا تعني أن النسب نفسها تنطبق على جميع المحادثات الانتخابية أو على الاستخدام اليومي للأنظمة.

ولم تتناول هذه المرحلة من البحث قياس دقة التوصيات الانتخابية أو انحيازها السياسي، بل ركزت على طبيعة أسئلة المستخدمين، واختلاف استجابات النماذج، ومدى استعدادها لتقديم اقتراحات بشأن المرشحين.

أهمية الحوار المتواصل

من الجوانب التي ركز عليها الباحثون تأثير تتابع الأسئلة والأجوبة داخل المحادثة الواحدة في طبيعة التوصيات التي يقدمها النظام؛ فبدلاً من الاكتفاء بسؤال منفرد، تتيح المحادثات متعددة المراحل للنموذج طرح أسئلة إضافية، والحصول على معلومات عن المستخدم، ثم تعديل استجاباته وفق الإجابات التي يتلقاها. وأشار الباحثون إلى أن الأسئلة التي يختارها النموذج تؤثر في نوع المعلومات التي يقدمها المستخدم، ومن ثم في التوصيات اللاحقة.

وتختلف هذه المقاربة عن دراسات سابقة تعتمد على توجيه مجموعة ثابتة من الأسئلة إلى أنظمة الذكاء الاصطناعي؛ إذ سمحت التجربة للمشاركين بالتفاعل مع الروبوتات بالطريقة التي يستخدمونها عادة للحصول على المعلومات. ويرى الباحثون أن دراسة هذه التفاعلات يمكن أن تساعد على تطوير اختبارات تقيس سلوك النماذج استناداً إلى الأسئلة التي يطرحها المستخدمون فعلياً، بدلاً من الاقتصار على سيناريوهات معدّة مسبقاً.

شملت الدراسة نحو 2500 مشارك من 35 ولاية أميركية يستخدمون روبوتات المحادثة أسبوعياً (أدوبي)

استخدام محدود على مستوى الناخبين

رغم اهتمام المشاركين في التجربة بالمعلومات الانتخابية، تشير بيانات منفصلة لمركز «بيو» للأبحاث إلى أن استخدام روبوتات المحادثة لهذا الغرض لا يزال محدوداً بين الأميركيين عموماً.

ففي استطلاع أجراه المركز خلال فبراير (شباط) 2026، أفاد 42 في المائة من البالغين الأميركيين باستخدام روبوتات المحادثة للبحث عن المعلومات بوجه عام. وفي استطلاع آخر أجراه خلال أكتوبر، قال 8 في المائة إنهم استخدموا هذه الأدوات للحصول على معلومات مرتبطة بالانتخابات خلال الدورة الانتخابية لعام 2026.

وتختلف هاتان النسبتان من حيث مدة جمع البيانات والغرض من السؤال، كما تختلفان عن عينة دراسة «ييل»، التي اقتصرت على أشخاص يستخدمون روبوتات المحادثة أسبوعياً؛ ولذلك لا يمكن تعميم نسبة 36 في المائة المسجلة في التجربة على جميع الناخبين الأميركيين.

وفي تحليل منفصل، قالت شركة «أنثروبيك» إنها فحصت 250 ألف محادثة مع نموذجها «كلود» خلال أكتوبر، ووجدت أن 0.51 في المائة منها تناولت الانتخابات أو التصويت، بينما بلغت نسبة المحادثات التي تضمنت طلبات مخالفة لسياساتها المتعلقة بنزاهة الانتخابات نحو 0.002 في المائة. وأوضحت الشركة أن المستخدمين كانوا يسألون في الغالب عن مواقف المرشحين من قضايا محددة، بدلاً من طلب تحديد الشخص الذي ينبغي التصويت له.

أسئلة حول الدقة والتأثير

لم تتناول دراسة «ييل» بصورة حاسمة مدى صحة المعلومات التي قدمتها روبوتات المحادثة، أو ما إذا كانت التوصيات قد أثرت فعلياً في قرارات التصويت لدى المشاركين.

ويحدد الباحثون مجالات عدة للبحث اللاحق، تشمل تقييم دقة إجابات النماذج ومدى توازنها، والمعلومات التي تستخلصها عن المستخدمين خلال المحادثات، وما إذا كانت توصياتها تتوافق مع احتياجاتهم وأولوياتهم المعلنة، كما يبرز التمييز بين تقديم معلومات تساعد الناخب على فهم مواقف المرشحين، وبين اقتراح مرشح محدد، بوصفه أحد الجوانب التي يمكن دراستها عند تقييم دور أنظمة الذكاء الاصطناعي في الحصول على المعلومات السياسية. وتوفر التجربة بيانات عن كيفية تفاعل مستخدمين فعليين مع أربعة من أبرز روبوتات المحادثة خلال مرحلة انتخابية، بينما تبقى مسألة تأثير هذه التفاعلات في اختياراتهم النهائية موضوعاً لأبحاث إضافية.


هل يمتلك الذكاء الاصطناعي شخصية؟... دراسة ألمانية تكشف عن الفروق بين كتاباته والنصوص البشرية

أظهرت النماذج اللغوية قدرة على إنتاج أنماط كتابة تعكس سمات شخصية بشرية دون أن يثبت ذلك امتلاكها شخصية فعلية (غيتي)
TT

هل يمتلك الذكاء الاصطناعي شخصية؟... دراسة ألمانية تكشف عن الفروق بين كتاباته والنصوص البشرية

أظهرت النماذج اللغوية قدرة على إنتاج أنماط كتابة تعكس سمات شخصية بشرية دون أن يثبت ذلك امتلاكها شخصية فعلية (غيتي)

أظهرت دراسة علمية حديثة أن المشاركين البشر تفوقوا على نماذج الذكاء الاصطناعي في التمييز بين النصوص البشرية والآلية خلال تجربة اعتمدت على أوصاف شخصية مكتوبة بالألمانية، رغم قدرة النماذج على إنتاج أنماط لغوية تعكس سمات شخصية محددة واستنتاج بعضها من نصوص قصيرة. وبلغ متوسط دقة البشر في تحديد مصدر النصوص 83.14 في المائة، مقابل 66.90 في المائة للنماذج اللغوية المشاركة في التقييم.

وأجرى الدراسة باحثون من قسم علم النفس في جامعة يوهانس غوتنبرغ بمدينة ماينز الألمانية، ونُشرت في دورية «ساينتيفيك ريبورتس» بعنوان «التعبير عن الشخصية وإدراكها لدى النماذج اللغوية الكبيرة والبشر».

وتناولت الدراسة ثلاثة أسئلة مترابطة، تتعلق بمدى قدرة النماذج اللغوية على إنتاج أنماط لغوية تتوافق مع سمات شخصية معينة، وإمكان استنتاج هذه السمات من النصوص، ومدى قدرة البشر والآلات على تحديد ما إذا كان كاتب النص إنساناً أم نموذج ذكاء اصطناعي.

7 نماذج و140 نصاً

شملت التجربة 70 مشاركاً بشرياً وسبعة نماذج لغوية، هي «تشات جي بي تي 4o» و«تشات جي بي تي 3.5» و«لاما 3» و«جيما» و«جيميناي» و«فاي 3» و«أوركا 2». وطلب الباحثون من المشاركين والنماذج الإجابة عن استبيانات نفسية معتمدة لقياس السمات الشخصية الخمس الكبرى، وهي الانفتاح على التجارب ويقظة الضمير والانبساط والتوافق والعصابية إلى جانب تقدير الذات والنرجسية.

كما طُلب منهم تقديم أوصاف مكتوبة عن أنفسهم، من خلال أسئلة تناولت طريقة رؤيتهم لذواتهم، وكيف يعتقدون أن الآخرين ينظرون إليهم، وتطلعاتهم المستقبلية، وسلوكهم في حالات الضغط وعدم اليقين.

وأنتج كل نموذج لغوي عشرة نصوص، ليصل إجمالي المواد التي خضعت للتقييم إلى 140 نصاً، نصفها كتبه مشاركون بشر والنصف الآخر أنتجته النماذج السبعة.

واستخدم الباحثون اللغة الألمانية في التفاعل مع النماذج، لضمان قابلية المقارنة مع المشاركين البشر الناطقين بها. وفي المرحلة التالية، تولى عشرة مقيّمين بشر وستة نماذج لغوية تقييم النصوص، من خلال تقدير السمات الشخصية التي تعكسها، وتحديد ما إذا كان كاتب كل نص إنساناً أم نموذج ذكاء اصطناعي.

حقق المشاركون البشر دقة بلغت 83.14 % في تحديد مصدر النصوص مقابل 66.90 % للنماذج اللغوية (أدوبي)

أنماط تشبه الشخصية البشرية

كشفت نتائج الاستبيانات عن اختلافات واضحة بين النماذج اللغوية في الطريقة التي تعبّر بها عن سمات الشخصية؛ إذ أنتج كل منها أنماطاً مميزة نسبياً ضمن ظروف الاختبار. وعند مقارنة متوسط نتائج النماذج السبعة بإجابات المشاركين البشر، سجلت النماذج درجات أعلى في التوافق ويقظة الضمير، ودرجات أقل في العصابية، وهي السمة المرتبطة بالميل إلى المشاعر السلبية وعدم الاستقرار الانفعالي.

وأظهر اختبار أُعيد إجراؤه بعد يوم واحد درجة مرتفعة من الاتساق في نتائج السمات الخمس الكبرى، بمعامل ارتباط بلغ 0.88، وهو مستوى وصفه الباحثون بأنه قابل للمقارنة مع القيم المسجلة عادة في العينات البشرية. لكن هذا الاتساق يتعلق بالاستجابات المسجلة في ظروف التجربة، ولا يثبت امتلاك النماذج سمات شخصية ثابتة أو مستقلة عن التعليمات التي تتلقاها. ويؤكد الباحثون أن هذه النتائج تعكس أنماطاً في توليد الإجابات، وليست دليلاً على وجود شخصية بشرية فعلية لدى الأنظمة. كما لاحظوا أن الاختلافات بين النماذج كانت أكثر وضوحاً في إجابات الاستبيانات المباشرة مقارنة بتقييمات الشخصية المستخلصة من النصوص الحرة؛ ما يشير إلى تأثير طريقة طرح الأسئلة في الصورة التي يقدمها النموذج عن نفسه.

قراءة الشخصية من الكلمات

لم تقتصر التجربة على تحديد مصدر النصوص، بل اختبرت قدرة المقيّمين على استنتاج سمات الشخصية البشرية اعتماداً على أوصاف مكتوبة قصيرة، ومقارنتها بالنتائج التي أفصح عنها المشاركون في الاستبيانات.

وأظهرت النتائج أن المقيّمين البشر والنماذج اللغوية استطاعوا تقدير ست سمات من أصل سبع بدقة تتجاوز مستوى المصادفة، في حين لم تحقق تقديرات النرجسية المستوى نفسه.

وبلغ متوسط معامل الارتباط بين أحكام المقيمين البشر ونتائج الاستبيانات 0.28، مقابل 0.33 لدى النماذج اللغوية. ويشير ذلك إلى تفوق محدود للنماذج في هذه المهمة ضمن عينة الدراسة، مع تقارب الأداء بين الطرفين.

كما سجل الباحثون اختلافات في طريقة تقييم النصوص. فقد منح المقيمون البشر النصوص التي أنتجها الذكاء الاصطناعي درجات أعلى من النصوص البشرية في معظم السمات الشخصية التي خضعت للقياس.

أما النماذج اللغوية المستخدمة في التقييم، فقد مالت عموماً إلى منح درجات أعلى للانفتاح ويقظة الضمير والتوافق وتقدير الذات، ودرجات أقل للنرجسية، مقارنة بتقييمات المقيّمين البشر.

وتوضح النتائج أن الكلمات المستخدمة في وصف الذات يمكن أن تنقل انطباعات شخصية قابلة للقياس، حتى عندما يكون مصدرها نموذجاً لغوياً لا تثبت هذه النتائج امتلاكه سمات شخصية فعلية.

حذَّر الباحثون من المبالغة في الثقة بالنماذج اللغوية عند تقييم الشخصيات ودعوا إلى تعزيز الشفافية والضوابط الأخلاقية (رويترز)

البشر يتفوقون في كشف المصدر

عندما انتقل الباحثون إلى اختبار القدرة على التمييز بين الكتابة البشرية والآلية، ظهر تفوق أكثر وضوحاً للمقيّمين البشر في هذه التجربة. فقد بلغ متوسط دقتهم 83.14 في المائة، مقارنة مع 66.90 في المائة للنماذج اللغوية. وتمكنت المجموعتان من التعرف على النصوص البشرية بصورة صحيحة في 95 في المائة من الحالات، لكن الفارق ظهر عند التعامل مع النصوص المنتجة آلياً.

إذ نجح المقيّمون البشر في تحديد 71 في المائة من النصوص التي كتبها الذكاء الاصطناعي، في حين لم تتجاوز النسبة 38 في المائة لدى النماذج المستخدمة في التقييم. وسجل نموذجا «جيما» و«جيميناي» أفضل النتائج بين المقيمين الآليين؛ إذ اقترب أداؤهما من متوسط دقة المقيّمين البشر. كما لاحظ الباحثون ميلاً لدى الطرفين إلى تصنيف النصوص على أنها بشرية، حتى عندما يكون مصدرها نموذجاً لغوياً. ولم تظهر النماذج قدرة أفضل على التعرف على النصوص التي أنتجتها هي نفسها، مقارنة بالنصوص الأخرى.

طول النص يكشف عن مصدره

لفهم أسباب هذه الفروق، استخدم الباحثون أداة التحليل اللغوي «LIWC»، التي تفحص المفردات وأنماط استخدام الكلمات والعلامات المرتبطة بالمشاعر والعمليات المعرفية وغيرها.

وأظهر التحليل أن النصوص المنتجة بواسطة النماذج اللغوية كانت أطول بصورة ملحوظة، واستخدمت مفردات وظيفية وتعبيرات مرتبطة بالزمن والعلاقات بدرجة أكبر. في المقابل، تضمنت النصوص البشرية مفردات أكثر ارتباطاً بالمشاعر والأنشطة الترفيهية.

وتوافقت هذه النتائج مع تفسيرات المشاركين لطريقة اتخاذ قراراتهم؛ إذ أشار ثمانية من أصل عشرة مقيّمين بشر إلى طول النص بوصفه إحدى العلامات التي دفعتهم للاعتقاد بأنه مكتوب بالذكاء الاصطناعي.

كما ذكر ستة منهم أن اللغة التحليلية المفرطة أو التقنية أو شديدة الصياغة كانت من المؤشرات التي اعتمدوا عليها.

ولمعرفة مدى تأثير طول النص وحده؛ أعاد الباحثون تحليل مجموعة فرعية من النصوص بعد تقليل الفروق في أطوالها. وانخفض متوسط دقة البشر إلى 74.29 في المائة، في حين بلغت دقة النماذج 67.38 في المائة.

وتشير هذه النتيجة إلى أن طول النص كان مؤشراً مهماً للمقيّمين البشر، لكنه لم يكن العامل الوحيد الذي مكّنهم من التمييز بين الكتابة البشرية والآلية.

حدود النتائج والمخاطر

يشير الباحثون إلى أن النتائج مرتبطة بالنماذج المختبرة وطريقة صياغة التعليمات وإعدادات توليد النصوص، ولا يمكن تعميمها تلقائياً على جميع أنظمة الذكاء الاصطناعي أو اللغات. كما أن حجم العينة محدود، والنصوص كُتبت بالألمانية ضمن مهام تتعلق بوصف الذات؛ ما يجعل النتائج مختلفة بطبيعتها عن اختبارات الأخبار أو المقالات أو المحادثات اليومية.

وتؤكد الدراسة أن ظهور سمات شخصية متسقة في إجابات النماذج لا يثبت امتلاكها شخصية فعلية، محذرة من الخلط بين محاكاة الصفات البشرية من خلال اللغة ووجود خصائص نفسية مستقرة وراء هذه الاستجابات. ويناقش الباحثون الاستخدامات المحتملة للنماذج اللغوية في تقييم الأفراد، بما في ذلك مجالات الصحة النفسية والموارد البشرية، مع التشديد على ضرورة إخضاع مثل هذه التطبيقات لتقييمات أخلاقية دقيقة، خصوصاً عندما تتصل بقرارات تؤثر في حياة الأشخاص.

كما تدعو الدراسة إلى تعزيز الشفافية في تعريف المستخدمين بالمحتوى المنتج آلياً؛ لتجنب إضفاء صفات بشرية على الأنظمة أو منحها ثقة تتجاوز ما تسمح به قدراتها الفعلية. ويقترح الباحثون توسيع الاختبارات مستقبلاً لفهم كيف يؤثر إدراك المستخدمين لشخصية النماذج اللغوية في طبيعة تفاعلهم معها، ومدى تغير القدرة على التمييز بين الإنسان والآلة مع تطور الأجيال الجديدة من هذه الأنظمة.


الاتحاد الأوروبي يعدّ «تيك توك» خطراً على الصحة النفسية

علم الاتحاد الأوروبي وشعار «تيك توك» في هذا الرسم التوضيحي (رويترز - أرشيفية)
TT

الاتحاد الأوروبي يعدّ «تيك توك» خطراً على الصحة النفسية

علم الاتحاد الأوروبي وشعار «تيك توك» في هذا الرسم التوضيحي (رويترز - أرشيفية)

خلصت نتائج أولية للمفوضية الأوروبية إلى أن تطبيق «تيك توك» يخالف قوانين الاتحاد الأوروبي عن طريق تعريض مستخدميه بشكل متواصل لمحتوى قد يضر بسلامتهم وصحتهم النفسية، وفق ما نقلته «وكالة الأنباء الألمانية».

وفي أغسطس (آب) الماضي، فرضت هيئة حماية البيانات البرازيلية غرامة قدرها نحو 29.8 مليون دولار على شركة «بايت دانس»، المالكة لتطبيق «تيك توك»، بسبب معالجة البيانات الشخصية للأطفال والمراهقين دون أسس قانونية كافية، وعدم اتخاذها التدابير المناسبة لمنع ذلك.

وفي أغسطس الماضي أيضاً، أعلنت وزارة العدل الأميركية إن منصة «تيك توك» وافقت على دفع 400 مليون دولار لتسوية مزاعم أميركية بشأن جمع البيانات الشخصية للأطفال.