جنسن هوانغ: «الذكاء الاصطناعي العام» وصل... فهل يستطيع العلم إثبات ذلك؟

تساؤلات في ميدان الطب: حوسبة أكبر... أم ذكاء أكبر؟

هل بدأ بزوغ عصر الذكاء الاصطناعي العام؟
TT

جنسن هوانغ: «الذكاء الاصطناعي العام» وصل... فهل يستطيع العلم إثبات ذلك؟

هل بدأ بزوغ عصر الذكاء الاصطناعي العام؟

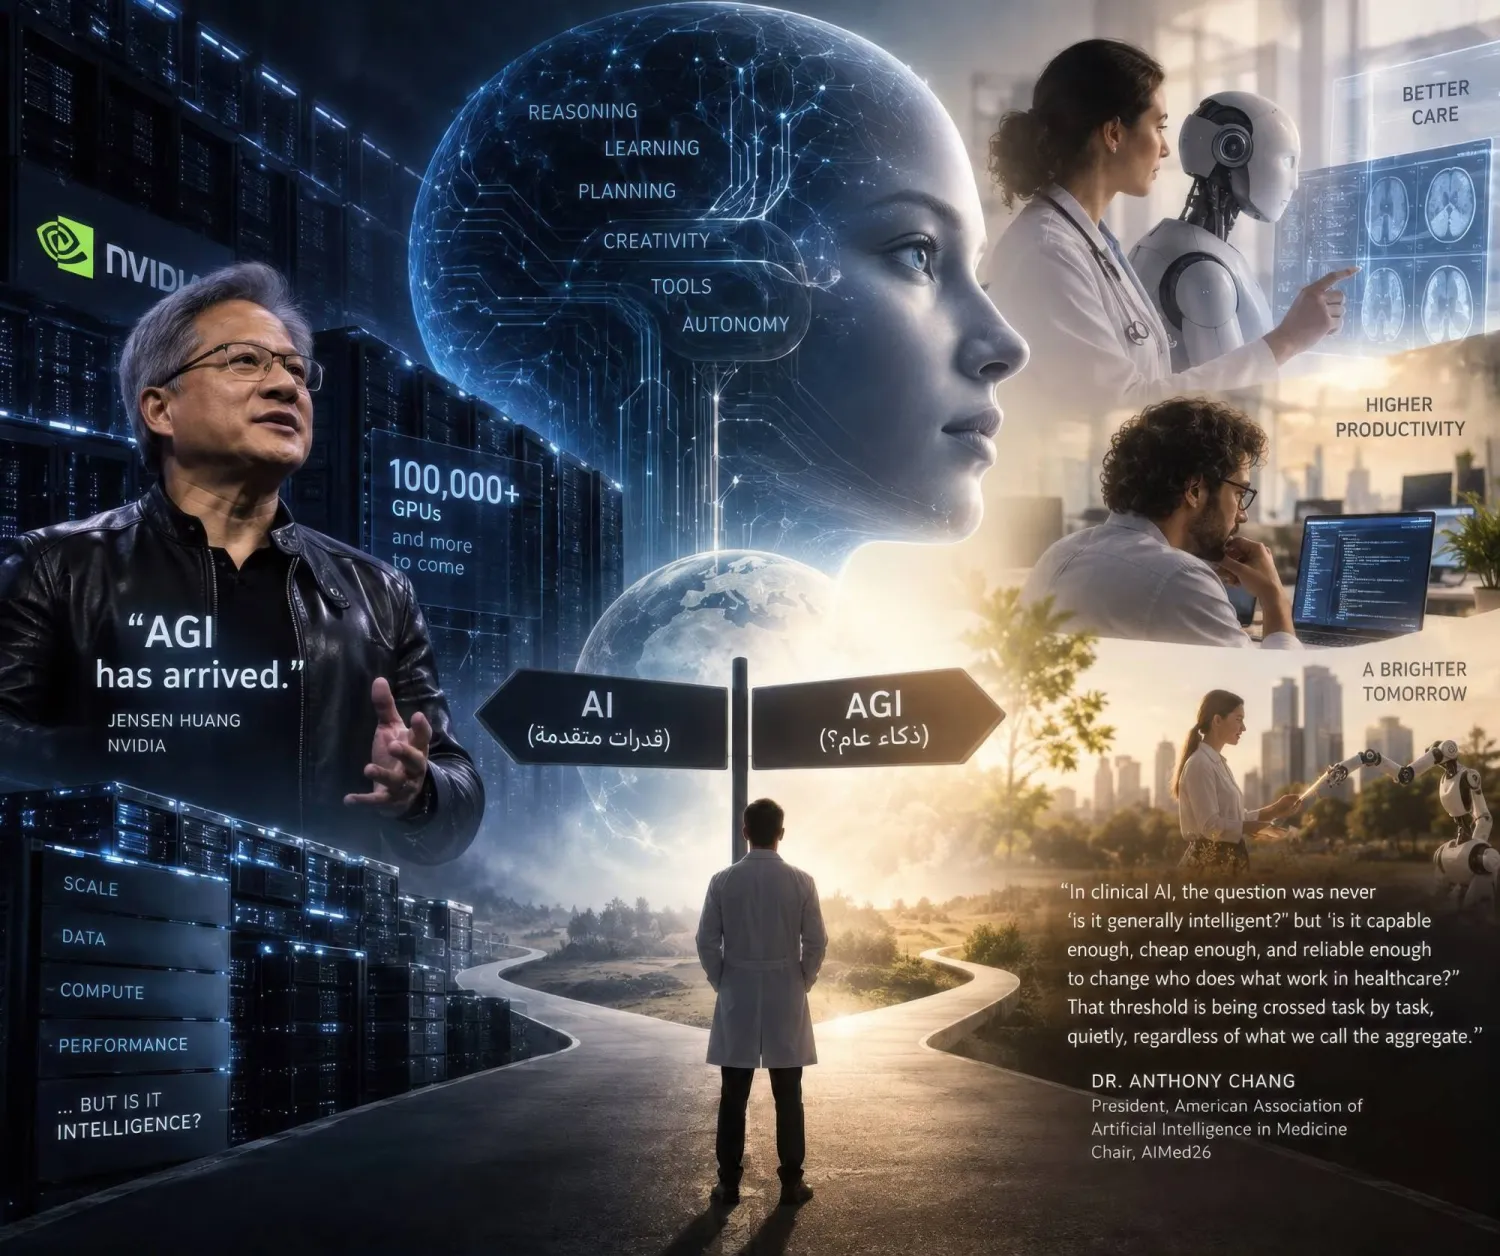
​«لقد وصل الذكاء الاصطناعي العام»... بهذه الكلمات أعاد جنسن هوانغ، الرئيس التنفيذي لشركة «إنفيديا» (NVIDIA)، في السادس من سبتمبر (أيلول) 2026، فتح واحد من أكبر الأسئلة في تاريخ الذكاء الاصطناعي.

فإذا كان «AGI» -أو الذكاء الاصطناعي العام- قد وصل بالفعل، فنحن لا نتحدث عن نموذج أسرع يكتب نصوصاً أفضل أو يحل مسائل أكثر تعقيداً؛ بل عن احتمال عبور الآلة عتبة ظل الباحثون لعقود يتساءلون عما سيحدث بعدها: متى يتوقف الذكاء الاصطناعي عن كونه أداة متخصصة، ويصبح ذكاءً قادراً على التعامل مع طيف واسع من المهام على نحو يقترب من الإنسان أو يتجاوزه؟

لكن هنا تبدأ المفارقة: إعلان الوصول إلى الذكاء الاصطناعي العام أسهل بكثير من إثباته. فحتى اليوم، لا توجد «شهادة علمية» لـ«AGI»، ولا اختبار عالمي متفق عليه يمكن أن نضع أمامه أحدث النماذج، ثم نقول بثقة: نعم، لقد عبرت الآلة الخط الفاصل.

وهنا يصبح السؤال أكثر إثارة: هل وصل الذكاء الاصطناعي العام فعلاً؟ أم أن قدرات الآلة أصبحت تتقدم أسرع من قدرتنا على تعريف ما نسميه «الذكاء»؟

عندما يصبح تعريف الذكاء هو المشكلة

يرمز «AGI» إلى «الذكاء الاصطناعي العام» (Artificial General Intelligence)، ويُستخدم عادة لوصف نظام لا يتفوق في مهمة واحدة فقط؛ بل يستطيع التعلم والاستدلال والتكيف، وإنجاز طيف واسع من المهام بمستوى يقارب الإنسان أو يتجاوزه.

وقد عرَّفت شركة «أوبن أيه آي» (OpenAI) المفهوم سابقاً بأنه أنظمة شديدة الاستقلالية تتفوق على البشر في معظم الأعمال ذات القيمة الاقتصادية.

لكن ما يبدو تعريفاً واضحاً للوهلة الأولى يفتح باباً لأسئلة أصعب: ما المقصود بـ«معظم الأعمال»؟ وهل التفوق على الإنسان في أداء مهمة يعني امتلاك ذكاء يشبه ذكاءه؟ وإذا استطاع نموذج أن يكتب برنامجاً، ويحل مسألة رياضية، ويحلل بيانات، ويستخدم الحاسوب، فكم قدرة إضافية يحتاج إليها قبل أن ننتقل من وصفه بـ«AI» إلى«AGI»؟

هنا لا يعود الخلاف مجرد سباق تقني بين نماذج أكثر قوة؛ بل يصبح معضلة علمية وفلسفية: كيف نثبت وصول شيء لم نتفق بعد على تعريفه؟
حوسبة أكبر... أم ذكاء أكبر؟

حوسبة أكبر... أم ذكاء أكبر؟

وراء القفزات الأخيرة في أداء الذكاء الاصطناعي توسع هائل في القدرة الحاسوبية والبيانات وأساليب التدريب. ومع كل جيل جديد، تستطيع النماذج إنجاز مهام كانت تبدو قبل سنوات قليلة بعيدة المنال.

لكن هنا يظهر سؤال لا يقل أهمية عن إعلان هوانغ نفسه: عندما نمنح النموذج حوسبة أكبر وبيانات أكثر وتدريباً أكثر تطوراً، ثم تتحسن قدراته بصورة مذهلة، فهل يمثل ذلك دليلاً على ظهور «ذكاء عام»، أم على اتساع نطاق المهام التي أصبح قادراً على أدائها؟

إن الفرق جوهري، فقد تتفوق الآلة في الرياضيات والبرمجة والبحث واستخدام الحاسوب، ثم تتعثر أمام سياق جديد، أو استثناء غير متوقع، أو مشكلة مفتوحة تختلف عما واجهته أثناء التدريب.

وتظهر هنا مفارقة لافتة: كلما اجتاز الذكاء الاصطناعي اختباراً كنا نظن أنه يتطلب قدرة بشرية، ارتفع السقف وبدأ البحث عن اختبار أصعب. فهل نحن نقترب من الذكاء العام؟ أم أن تعريفنا للذكاء يبتعد كلما اقتربت منه الآلة؟

ما الذي لا تقيسه الاختبارات؟

الذكاء البشري ليس مجموع درجات في اختبارات. فهو يشمل أيضاً القدرة على نقل ما نتعلمه من موقف إلى آخر، وفهم السياق، والتعامل مع الغموض، والتعلم من خبرات محدودة، واتخاذ القرار عندما لا تكون القواعد مكتوبة سلفاً.

ولهذا، ربما لا يكون السؤال الأهم: كم اختباراً يستطيع النموذج أن يتفوق فيه على البشر؟ بل: ماذا يفعل عندما ينتهي الاختبار ويبدأ العالم الحقيقي؟ فالاختبار يمنح النموذج مشكلة محددة ومعياراً للنجاح، أما العالم الحقيقي فيقدم مواقف متغيرة ومعلومات ناقصة ونتائج قد لا تظهر إلا لاحقاً. وهنا يصبح التفوق في الاختبارات دليلاً مهماً على القدرة، ولكنه ليس بالضرورة، -بمفرده- دليلاً حاسماً على الوصول إلى ذكاء اصطناعي عام.

ومع ذلك، ثمة مفارقة أخرى: ماذا لو لم نكن بحاجة إلى حسم هذا الجدل أصلاً قبل أن يبدأ الذكاء الاصطناعي في تغيير العالم الحقيقي؟

تساؤلات الطب

وفي الطب تحديداً، يبدو هذا السؤال أكثر إلحاحاً. في الطب... هل نسأل السؤال الخطأ؟ هنا يقدم الطب زاوية مختلفة تماماً.

ففي تصريح لـ«الشرق الأوسط»، ينقل الدكتور أنتوني تشانغ، رئيس الجمعية الأميركية للذكاء الاصطناعي في الطب ورئيس مؤتمر «AIMed26»، النقاش من سؤال: «ما الذكاء؟» إلى سؤال أكثر عملية: ماذا يستطيع أن يفعل؟

يقول تشانغ: «في الذكاء الاصطناعي السريري، لم يكن السؤال المهم سريرياً يوماً: هل هو ذكي بصورة عامة؟ بل: هل أصبح قادراً بما يكفي، ومنخفض التكلفة بما يكفي، وموثوقاً بما يكفي، لكي يغيِّر من يقوم بأي عمل في الرعاية الصحية؟».

ثم يضيف عبارة تختصر تحولاً قد يكون جارياً بالفعل: «هذه العتبة يجري تجاوزها، مهمة بعد أخرى، وبهدوء، بصرف النظر عما نطلقه على الصورة الكلية».

هل تستطيع الآلة أداء المهمة الطبية بصورة جيدة وموثوقة وبتكلفة مقبولة؟

هنا يتغير السؤال كله. فبالنسبة إلى الطبيب أو المستشفى، قد لا يكون السؤال العاجل ما إذا كان النظام يستحق لقب «AGI»، ولا انتظار لحظة تاريخية يعلن فيها العالم وصول الذكاء الاصطناعي العام. السؤال الأكثر عملية هو: هل تستطيع الآلة أداء هذه المهمة بصورة جيدة، وموثوقة، وبتكلفة مقبولة؟

فإذا أصبحت قادرة على تحليل صورة طبية، أو تلخيص ملف مريض، أو إعداد مسودة تقرير، أو دعم قرار سريري، فإن توزيع بعض المهام بين الإنسان والآلة يكون قد بدأ يتغير فعلاً، حتى لو استمر العلماء سنوات أخرى في الاختلاف على تعريف «AGI».

وهنا ربما تكمن المفارقة: قد يستمر العالم في الجدل حول اسم الذكاء الجديد، بينما يكون هذا الذكاء قد بدأ فعلاً في تغيير مَن يفعل ماذا داخل المستشفى.
التعليم يصنع المستقبل

الثورة التي قد تحدث بلا إعلان

وربما تكمن هنا المفارقة الأكبر. لقد تخيلنا طويلاً وصول الذكاء الاصطناعي العام كلحظة تاريخية واضحة: آلة تعبر عتبة فاصلة، ثم يستيقظ العالم في اليوم التالي وقد دخل عصر «AGI»، ولكن التحول الحقيقي قد يحدث بطريقة أكثر هدوءاً.

مهمة كانت تستغرق ساعة تُنجز في دقائق، تحليل كان يتطلب عملاً متخصصاً يصبح مدعوماً بخوارزمية، برنامج كان ينتظر أمراً بعد آخر، يصبح قادراً على تنفيذ سلسلة كاملة من الخطوات، ثم مهمة أخرى... ثم أخرى.

ومع تراكم هذه التحولات الصغيرة، قد تتغير العلاقة بين الإنسان والآلة، من دون لحظة واحدة نستطيع أن نشير إليها ونقول: «هنا بدأ كل شيء». وهنا تكتسب عبارة تشانغ «مهمة بعد أخرى، وبهدوء» معناها الأعمق: قد لا نعرف اللحظة التي وصل فيها الذكاء الاصطناعي العام؛ لأن العالم ربما يكون قد بدأ يتغير قبل أن نتفق على ما نسميه.

من يملك حق إعلان وصول «AGI»؟

قد يثبت التاريخ أن جنسن هوانغ كان محقاً، وأن عام 2026 كان بالفعل بداية عصر الذكاء الاصطناعي العام. وقد يثبت أننا كنا لا نزال أبعد عن تلك العتبة مما تصورنا. ولكن إعلان هوانغ يترك وراءه سؤالاً ربما يكون أهم من الإعلان نفسه: من يملك حق القول إن «AGI» قد وصل؟ هل هي الشركات التي تبني النماذج؟ أم العلماء الذين يختبرونها؟ أم المؤسسات والمجتمعات التي ستعيش آثارها؟ أم أننا لن ندرك أننا عبرنا العتبة إلا عندما ننظر إلى الوراء؟

وفي الطب، قد تكون الإجابة أكثر تعقيداً. فقد لا نحتاج إلى لحظة واحدة تصبح فيها الآلة «ذكية مثل الإنسان» حتى نشهد تحولاً عميقاً في طريقة العمل. يكفي أن تتراكم القدرات، وأن تتغير المهام والأدوار، وأن يصبح ما كان مستحيلاً بالأمس جزءاً من الممارسة اليومية.

وربما لهذا لن يحسم تاريخ الذكاء الاصطناعي سؤال «متى وصل AGI؟» بذكر يوم واحد أو نموذج واحد أو تصريح واحد. فقد نختلف طويلاً حول اللحظة التي أصبحت فيها الآلة «ذكية بما يكفي».

لكننا قد نكتشف، ونحن منشغلون بتعريف تلك اللحظة، أن العالم كان قد عبرها فعلاً.

مقالات ذات صلة

«إنفيديا» قد تواصل تمويل طفرة الذكاء الاصطناعي بعد هوانغ... لكن بشهية أقل للمخاطرة

الاقتصاد الرئيس التنفيذي لشركة «إنفيديا» جينسن هوانغ عقب مشاركته في حفل استقبال بخصوص «منظومة الذكاء الاصطناعي» في طوكيو (رويترز)

«إنفيديا» قد تواصل تمويل طفرة الذكاء الاصطناعي بعد هوانغ... لكن بشهية أقل للمخاطرة

من غير المرجح أن تختفي آلية «إنفيديا» لتمويل استثمارات الذكاء الاصطناعي، البالغة قيمتها 500 مليار دولار، مع رحيل المؤسس المشارك للشركة جينسن هوانغ عنها...

«الشرق الأوسط» (نيويورك)
الاقتصاد ترمب يقف إلى جانب الرئيس التنفيذي لـ«إنفيديا» جنسن هوانغ عقب منحه الميدالية الوطنية للعلوم خلال قمة «عصر ذهبي جديد» في معهد السلام الأميركي بواشنطن 8 أكتوبر 2026 (رويترز)

«واشنطن بوست»: ترمب يرفع استثماراته في «إنفيديا» إلى 62 مليون دولار

أفادت صحيفة «واشنطن بوست» بأن تعاملات الرئيس الأميركي دونالد ترمب المعلنة تشير إلى امتلاكه أسهماً في شركة «إنفيديا» بقيمة تتراوح بين 13 و62 مليون دولار.

«الشرق الأوسط» (واشنطن)
الاقتصاد متداولون يعملون في قاعة بورصة نيويورك (رويترز)

العقود الآجلة لـلأسهم الأميركية تتراجع وسط اضطرابات «إنفيديا» وترقب طرح «أنثروبيك»

تراجعت العقود الآجلة المرتبطة بمؤشرَي «ستاندرد آند بورز 500» و«ناسداك 100»، يوم الاثنين، مع تعرض الأسهم المرتبطة بالذكاء الاصطناعي لضغوط.

«الشرق الأوسط» (نيويورك (الولايات المتحدة))
الاقتصاد مايكل بار عضو مجلس محافظي «الفيدرالي» الأميركي (رويترز)

مسؤول في «الفيدرالي» يحذر من تداعيات الذكاء الاصطناعي على استقرار النظام المالي

حذّر مايكل بار، عضو مجلس محافظي «الاحتياطي الفيدرالي» الأميركي، يوم الاثنين، من مجموعة واسعة من المخاطر التي قد يفرضها الذكاء الاصطناعي على أنشطة التداول.

«الشرق الأوسط» (نيويورك (الولايات المتحدة))
الاقتصاد شاشة تعرض مؤشر نيكي الياباني في طوكيو (رويترز)

الأسهم العالمية تتراجع وسط ترقب نتائج «إنفيديا» وطرح «أنثروبيك»

تراجعت الأسهم العالمية، الاثنين، بعد أسبوع اتسم بتقلبات حادة، اختُتم بالرحيل المفاجئ لجنسن هوانغ عن منصبه رئيساً تنفيذياً لشركة «إنفيديا».

«الشرق الأوسط» (سيدني - لندن)

نجم ميت يرسل إشارات راديوية غامضة كل 8 دقائق... ماذا اكتشف العلماء؟

اكتشف علماء زوجاً نجمياً غريباً يبعد أكثر من 5 آلاف سنة ضوئية عن الأرض (بيكسلز)
TT

نجم ميت يرسل إشارات راديوية غامضة كل 8 دقائق... ماذا اكتشف العلماء؟

اكتشف علماء زوجاً نجمياً غريباً يبعد أكثر من 5 آلاف سنة ضوئية عن الأرض (بيكسلز)

في اكتشاف فلكي جديد قد يساعد على فك لغز بعض الإشارات الراديوية الغامضة الآتية من أعماق مجرة درب التبانة، تمكن علماء فلك من تحديد مصدر هذه الإشارات في نظام نجمي غير مألوف، يبعد أكثر من 5 آلاف سنة ضوئية عن الأرض، ويضم نجماً ميتاً يدور حول نفسه مرة كل 8 دقائق، ونجماً آخر يشبه الشمس إلى حد كبير.

وحسب موقع «ساينس ديلي» العلمي، فقد تم هذا الاكتشاف من قِبل باحثين في فرع جامعة كيرتن التابعة للمركز الدولي لبحوث علم الفلك الراديوي، حيث وجدوا أن النظام النجمي المكتشف يجمع بين قزم أبيض ونجم من النوع الطيفي «جي» (وهي فئة من النجوم متوسطة الحرارة يميل لونها إلى الأصفر المائل للأبيض، وتُعد الشمس أشهر مثال عليها) يدوران حول بعضهما بعضاً.

نظام نجمي غير مألوف وإشارات تحير العلماء

يحمل النظام النجمي المكتشف اسم «جي بي إم جاي 071507-114153»، وينتمي إلى فئة فلكية نادرة تُعرف باسم الأجسام العابرة طويلة الفترة، وهي أجسام تصدر إشارات راديوية تظهر وتختفي على فترات تتراوح بين عدة دقائق وساعات.

ويتكون النظام من قزم أبيض، وهو بقايا نجم شديد الكثافة استنفد وقوده النووي وتخلص من طبقاته الخارجية، إلى جانب نجم يشبه الشمس، ويدور القزم الأبيض حول نفسه مرة كل 8 دقائق.

وتكمن أهمية الاكتشاف في أنه يمثل المرة الأولى التي يرصد فيها العلماء إشارات راديوية غامضة صادرة عن نظام يجمع بين قزم أبيض ونجم شبيه بالشمس، بعدما اقتصرت الاكتشافات السابقة لهذه الظاهرة على أنظمة تضم أقزاماً بيضاء ونجوماً أصغر حجماً وأكثر برودة.

كيف حدد العلماء مصدر الإشارات؟

حلل الباحثون أكثر من 100 ساعة من المشاهدات الراديوية، مستعينين بإمكانات الحوسبة المتقدمة في مركز باوسي لأبحاث الحوسبة الفائقة.

وقد رصدوا مصدر النبضات التي كانت دقيقة بما يكفي لتحديد موقع النظام النجمي.

وقال الباحث الرئيسي في الدراسة، الدكتور سام ماك سويني: «هذه هي المرة الأولى التي تكون فيها النبضات واضحة بما يكفي لرؤية القزم الأبيض وهو يتحرك في مداره حول النجم المرافق له، ولذلك علمنا أن النبضات تأتي من منطقة قريبة من القزم الأبيض، أو ربما من القزم الأبيض نفسه».

عواصف مغناطيسية على بعد 5 آلاف سنة ضوئية

لم تقتصر أهمية الإشارات المكتشفة على تحديد موقع القزم الأبيض، بل كشفت أيضاً عن نشاط مغناطيسي قوي على النجم الشبيه بالشمس، تمثل في رصد توهجات نجمية واضطرابات مغناطيسية شديدة.

وقالت الأستاذة المشاركة في الدراسة، ناتاشا هيرلي ووكر: «كشفت الملاحظات عن نشاط يشبه العمليات المغناطيسية التي تحدث على سطح الشمس، والتي يمكن أن تؤدي إلى ظهور الشفق القطبي على الأرض عندما تتفاعل الجسيمات النشطة مع المجال المغناطيسي لكوكبنا وغلافه الجوي».

ورصد الفريق كذلك مرور القزم الأبيض خلف منطقة شديدة النشاط المغناطيسي بالقرب من النجم المرافق، يُرجح أنها «نتوء نجمي»، وهو عبارة عن حلقة كبيرة من البلازما تنبثق من سطح النجم، وتظل معلقة بفعل المجالات المغناطيسية.

وقالت هيرلي ووكر: «من المدهش أننا نستطيع، باستخدام الموجات الراديوية، رصد العواصف على نجم يبعد أكثر من 5 آلاف سنة ضوئية».

ونُشرت نتائج الدراسة في دورية علم الفلك الطبيعي، تحت عنوان «جسم عابر طويل الفترة له نجم مرافق يشبه الشمس»، في خطوة علمية قد تساعد على فهم طبيعة الإشارات الراديوية الغامضة، والكشف عن مزيد من أسرار الأنظمة النجمية النادرة في مجرتنا.


الذكاء الاصطناعي يشخّص المرض بالإنجليزية فهل يتعثر بالعربية؟

الذكاء الاصطناعي يشخّص المرض بالإنجليزية فهل يتعثر بالعربية؟
TT

الذكاء الاصطناعي يشخّص المرض بالإنجليزية فهل يتعثر بالعربية؟

الذكاء الاصطناعي يشخّص المرض بالإنجليزية فهل يتعثر بالعربية؟

تخيّل مريضين يقدّمان حالتين سريريتين متماثلتين، إلى نموذج ذكاء اصطناعي. الأول يكتب بالإنجليزية، والآخر بالعربية. هل يحصلان على التشخيص نفسه؟

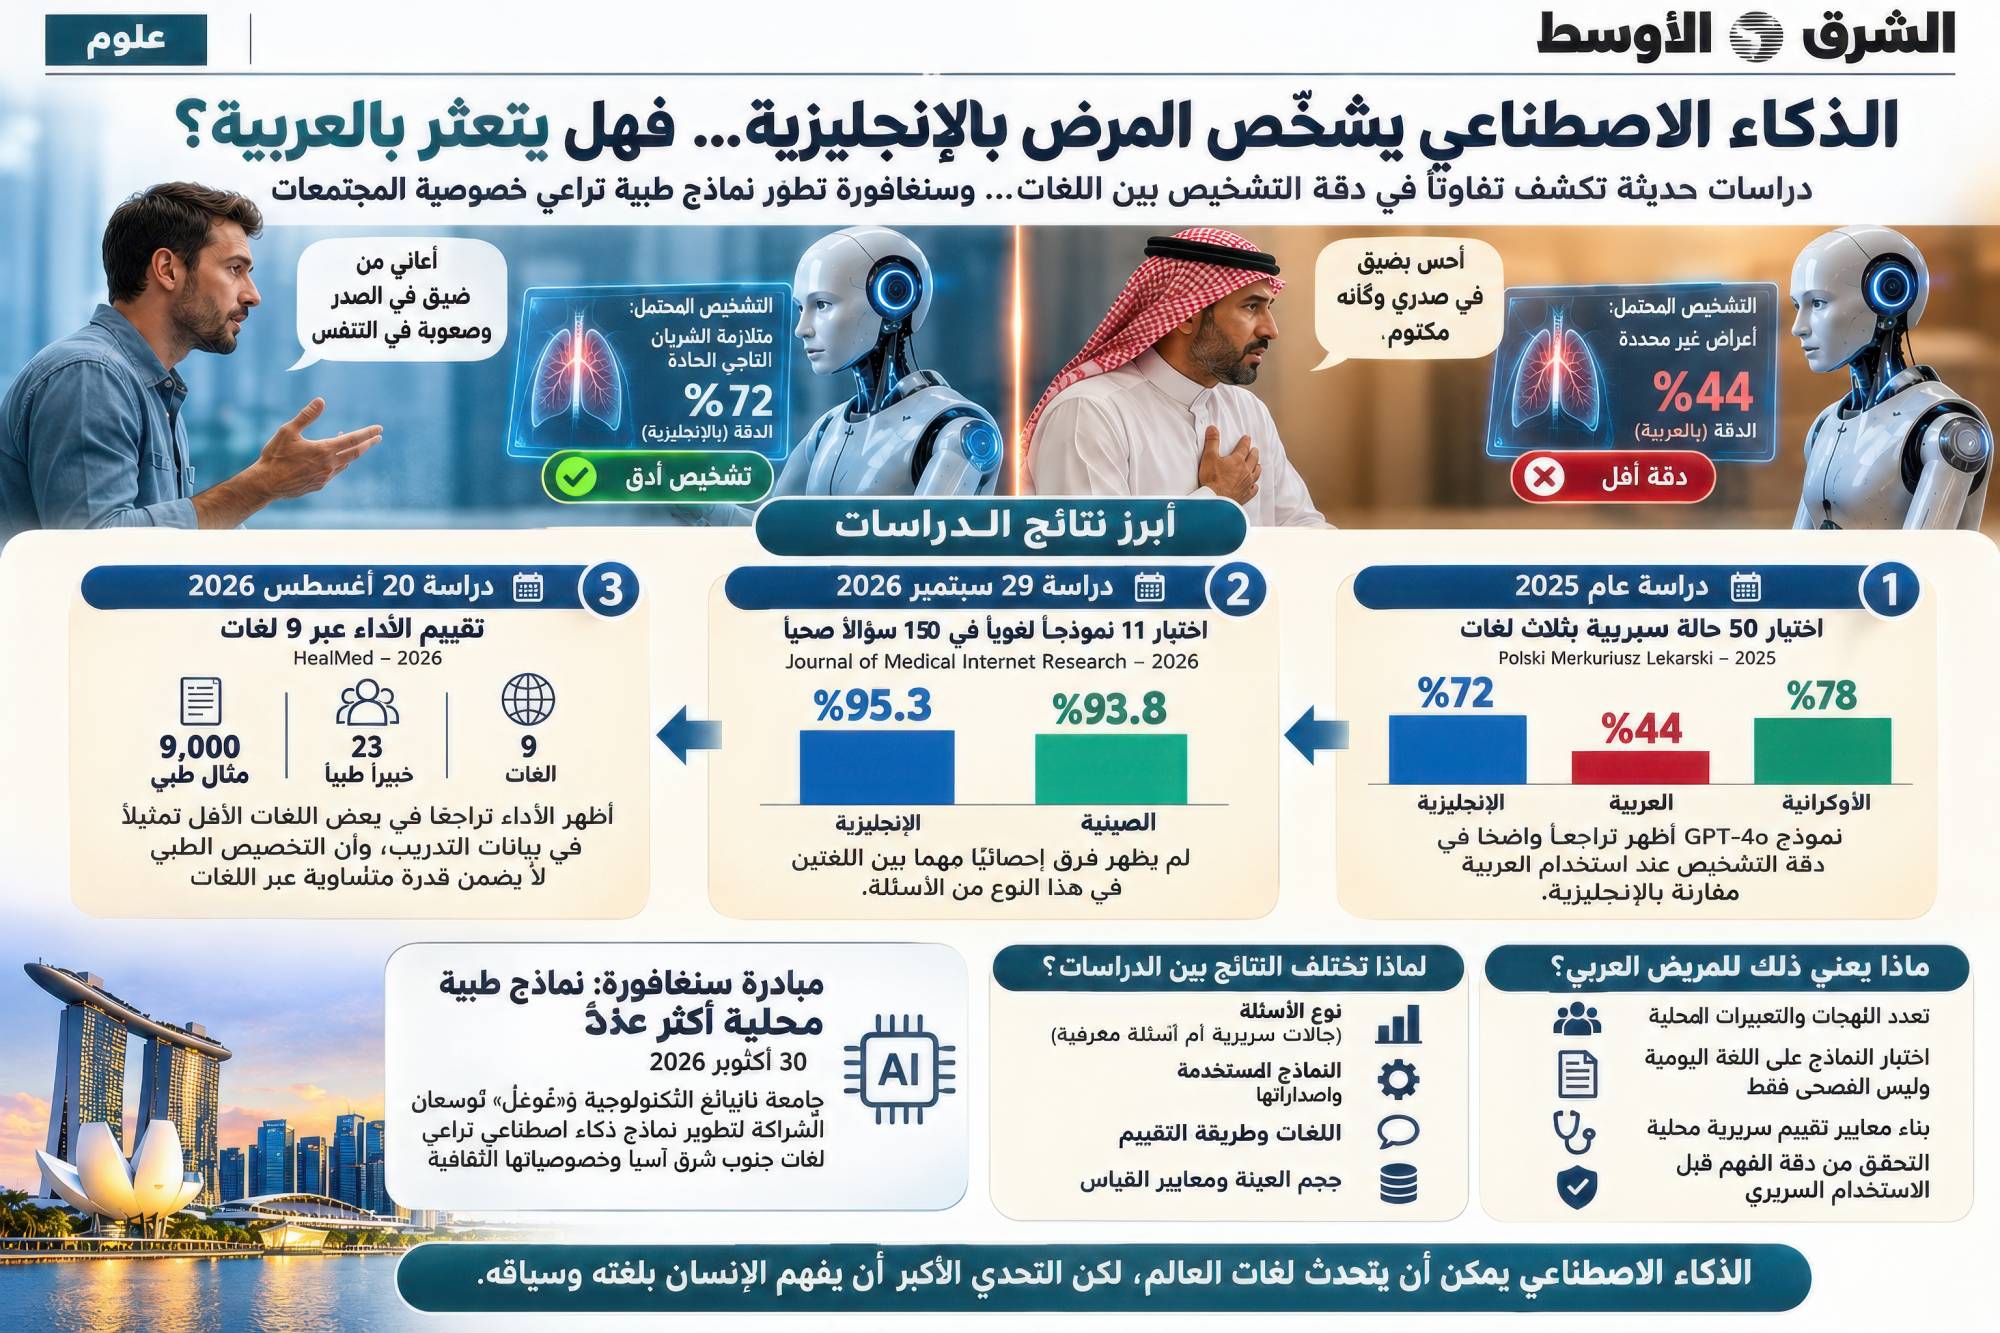
قد يبدو السؤال مستغرباً في زمن تعلن فيه النماذج قدرتها على فهم عشرات اللغات. لكن دراسة قارنت أداء برنامج ChatGPT- 4o في 50 حالة سريرية، وجدت أن دقته بلغت 72 في المائة بالإنجليزية، مقابل 44 في المائة بالعربية.

لم يتغير المرض أو جوهر المعلومات السريرية؛ بل تغيرت اللغة التي عُرضت بها الحالة. فهل يمكن أن تصبح لغة المريض عاملاً يؤثر في جودة المساعدة الطبية التي يتلقاها من الذكاء الاصطناعي؟

مفاجآت الذكاء الاصطناعي اللغوية

• مفاجأة الأرقام. في دراسة نُشرت عام 2025 في مجلة Polski Merkuriusz Lekarski، اختبر الباحثان الحبيب المهداوي وياروسلاف ميخالكُو نموذجَي «GPT-4o» و«Claude 3.5 Sonnet» في تشخيص 50 حالة سريرية عُرضت بالإنجليزية والعربية والأوكرانية.

بلغت دقة 72 «GPT-4o» في المائة بالإنجليزية و70 في المائة بالأوكرانية، لكنها هبطت إلى 44 في المائة بالعربية. وظهر تفاوت مماثل لدى «Claude 3.5 Sonnet»؛ إذ بلغت دقته 70 في المائة بالإنجليزية و38 في المائة بالعربية. وكان أداء النموذجين بالعربية أقل بدرجة ذات دلالة إحصائية.

ولا تعني هذه النتائج أن جميع أنظمة الذكاء الاصطناعي الطبي تعجز عن فهم العربية؛ فالدراسة اختبرت 50 حالة ونموذجين بإصدارين محددين. لكنها تثير سؤالاً مهماً: هل يمكن لنموذج يمتلك معرفة طبية واسعة أن يطبقها بدقة متفاوتة حسب لغة الحالة؟ فالمريض لا يختار لغته بناءً على قدرات الخوارزمية، لكن جودة الإجابة قد تتأثر باللغة التي يصف بها حالته.

• سنغافورة تدخل السباق. في 30 أكتوبر (تشرين الأول) الماضي، أعلنت جامعة نانيانغ التكنولوجية في سنغافورة توسيع شراكتها مع «غوغل» في الذكاء الاصطناعي، بما يشمل تطوير نماذج تراعي لغات جنوب شرقي آسيا وخصوصياتها الثقافية.

وتتضمن المبادرة، بالتعاون مع برنامج «AI Singapore»، جمع مجموعات بيانات لغوية إقليمية وإتاحتها، ووضع أطر مستقلة لتقييم النماذج في سياقات المنطقة. كما يسعى الشركاء إلى تطوير نماذج سيادية للتعليم والرعاية الصحية، باستخدام نماذج «غوغل» المفتوحة، مثل «Gemma» و«MedGemma».

ولا تعني المبادرة أن نماذج طبية محلية أثبتت نجاحها سريرياً؛ إذ إنها شراكة بحثية وتطويرية تعكس تحولاً في السؤال: لم يعد كافياً أن يتحدث الذكاء الاصطناعي لغات أكثر، بل ينبغي التحقق من دقة فهمه للمعاني الطبية في بيئات مختلفة. فاللغة الطبية ليست قاموساً للمصطلحات؛ إنها أيضاً الطريقة التي يصف بها الإنسان ألمه وخوفه وتاريخه الصحي.

• دراسة أخرى تقلب الصورة. لكن المفاجأة العلمية لا تتوقف عند تفاوت الأداء بالعربية. ففي 29 سبتمبر (أيلول) الماضي، نشرت مجلة Journal of Medical Internet Research دراسة اختبرت 11 نموذجاً لغوياً في الإجابة عن 150 سؤالاً صحياً بالإنجليزية والصينية، وكانت الإجابات المطلوبة ثنائية، مثل «نعم» أو «لا».

بلغت الدقة الإجمالية، عند الإجابة من دون سياق إضافي، 95.3 في المائة بالإنجليزية و93.8 في المائة بالصينية، من دون فرق إحصائي ذي دلالة بين اللغتين.

فهل تتناقض الدراستان؟ ليس بالضرورة؛ لأن الأولى اختبرت تشخيص حالات سريرية، والأخرى أسئلة صحية محددة الإجابة. كما اختلفت النماذج واللغات وطرق القياس.

وهذا يوضح أن كفاءة الذكاء الاصطناعي الطبي لا تُختزل في رقم واحد يصلح لكل اللغات والمهام. فقد يجيب النظام بدقة عن سؤال صحي مباشر، ثم يواجه صعوبة أكبر في تفسير قصة مرضية تتضمن تعبيرات محلية أو تفاصيل سريرية معقدة.

اللغات تحت المجهر

• التقييم بتسع لغات. في 20 أغسطس (آب) الماضي، نشر فريق دولي على منصة arXiv دراسة أولية بعنوان «HealMed»، قدمت معياراً لتقييم النماذج الطبية بتسع لغات. وطوّر المعيار 23 طبيباً وخبيراً طبياً من تسع دول ومناطق. ضمّ المعيار 9000 مثال، موزعة على مهام طبية متعددة.

وأظهرت النتائج تراجعاً أكبر في بعض اللغات الأقل تمثيلاً في بيانات التدريب. كما لم تكن النماذج المتخصصة طبياً بالضرورة الأكثر ثباتاً بين اللغات. وتبيّن أيضاً أن مراجعة الخبراء للترجمات قد ترفع نتائج الاختبار أو تخفضها؛ فجودة الترجمة جزء من دقة التقييم، وليست تفصيلاً لغوياً. وتستحق هذه النتائج المتابعة، لكن الدراسة لا تزال أولية، ولم تخضع بعد لمراجعة علمية محكّمة.

• اللغة وجودة الرعاية. لا تتعلق المسألة بقدرة النموذج على فهم كلمات عربية فحسب، بل بمدى تكافؤ المساعدة الطبية بين اللغات. فإذا كان النظام أقل دقة عند التعامل مع العربية، فقد ينعكس ذلك على فهم الحالة أو تفسير المعلومات التي يقدمها للمريض. لذلك؛ ينبغي ألا يقتصر اختبار النماذج الطبية على قياس قدرتها على الإجابة، بل أن يقارن أداءها بين اللغات في المهام السريرية نفسها. فإتاحة الأداة للجميع لا تكفي؛ المهم أن تكون فائدتها موثوقة بالقدر نفسه.

• اللغة جزء من سلامة العلاج. كان ابن سينا ينظر إلى المريض في سياق حالته وأحواله، في حين جعل ابن رشد البرهان والاختبار أساساً للحكم على صحة المعرفة. وبين المنهجين تبرز رسالة الدراسات الحديثة: لا يكفي أن نعلن أن النموذج الطبي يفهم العربية؛ بل ينبغي أن نختبر دقته في مهام سريرية محددة.

وتفتح تجربة سنغافورة مجالاً أمام الجامعات والمؤسسات الصحية العربية لتطوير اختبارات تقيس أداء النماذج قبل استخدامها مع المرضى، وتقارن دقتها في اللغات المختلفة وفق معايير واضحة. فالمساواة في الرعاية الرقمية لا تتحقق بمجرد إتاحة التطبيق للجميع، بل بالتأكد من أن اللغة لا تقلل موثوقية المعلومة الطبية.

لقد تعلّم الذكاء الاصطناعي أن يتحدث بلغات العالم؛ أما التحدي، فهو أن يفهم المعنى الطبي بدقة، وأن يثبت ذلك بالاختبار.

الصور ومصادرها

1. طبيب يتحدث إلى مريضة في العيادة

المصدر: المعاهد الوطنية الأميركية للصحة (NIH). تصوير: Bill Branson

الترخيص: ملكية عامة (Public Domain). ويُسمح بإعادة استخدامها دون إذن أو رسوم

2. إعداد توضيحي خاص بالمقالة

سنغافورة تطور نماذج طبية تفهم خصوصية المجتمعات


26 جيناً نادراً ترتبط بانخفاض القدرات المعرفية

26 جيناً نادراً ترتبط بانخفاض القدرات المعرفية
TT

26 جيناً نادراً ترتبط بانخفاض القدرات المعرفية

26 جيناً نادراً ترتبط بانخفاض القدرات المعرفية

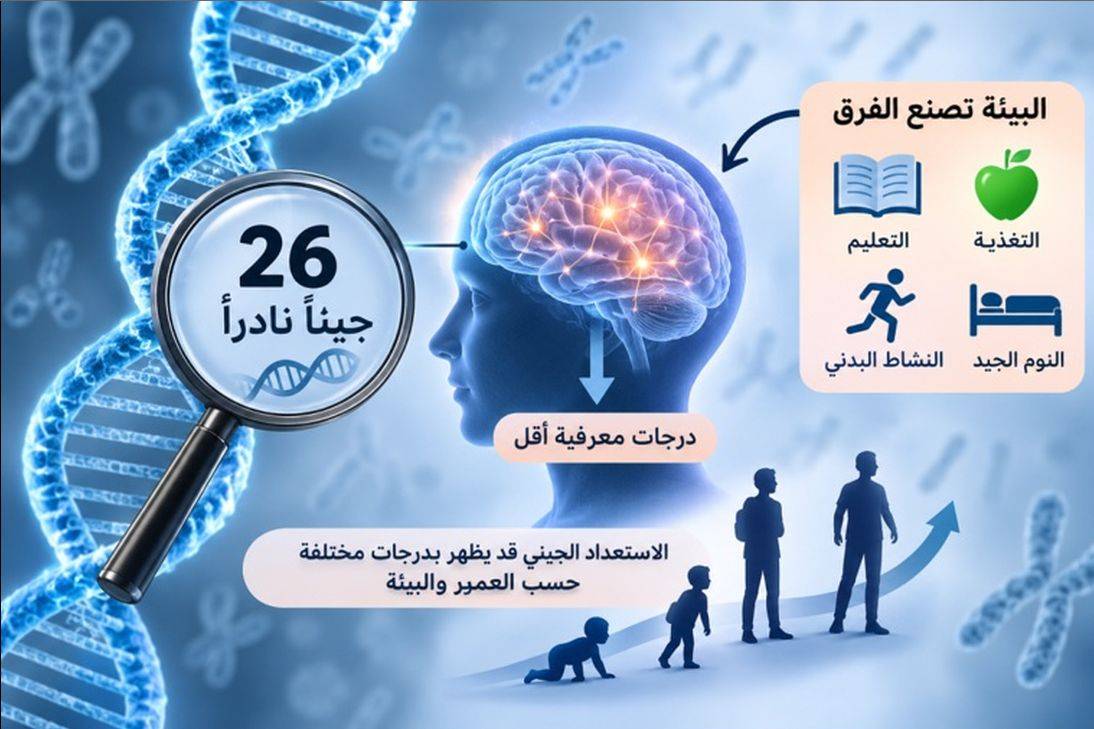
كشفت دراسة جينية واسعة شملت أكثر من 455 ألف شخص، عن 26 جيناً ترتبط التغيرات النادرة فيها بانخفاض درجات الاختبارات المعرفية لدى الإنسان، وذلك في اكتشاف يعزز فهم العوامل الوراثية المؤثرة في القدرات الذهنية، ويسلط الضوء على العلاقة المعقدة بين الجينات ونمو الدماغ والظروف المحيطة بالإنسان.

وتأتي هذه النتائج ضمن مجموعة من الأبحاث الحديثة المنشورة عام 2026 التي تشير إلى أن الجينات لا تحدّد القدرات المعرفية بصورة منفردة، بل يتغير تأثيرها خلال مراحل النمو ويتداخل مع عوامل نفسية وسلوكية قد تؤثر في التعلم والتحصيل الدراسي.

اكتشاف جينات جديدة

وشملت الدراسة التي نُشرت في الخامس من أكتوبر (تشرين الأول) الماضي في مجلة Nature Genetic بيانات أكثر من 455 ألف شخص من أصول أوروبية، مستفيدة من معلومات البنك الحيوي البريطاني UK Biobank. وأجرى البحث علماء من معهد «ويلكوم سانغر» والمركز الطبي لجامعة أمستردام الهولندية بالتعاون مع باحثين آخرين.

وكانت دراسات سابقة اعتمدت على نتائج اختبار للاستدلال اللفظي والعددي يقيس مهارات حل المشكلات، لكن نحو 40 في المائة من المشاركين في البنك الحيوي البريطاني لم يخضعوا لهذا الاختبار. كما كان الأشخاص الذين أكملوه أكثر ميلاً إلى امتلاك مستويات تعليمية أعلى؛ ما قد يؤدي إلى تحيز في العينة.

ولمعالجة هذه المشكلة؛ استخدم الباحثون معلومات صحية وسلوكية واجتماعية واقتصادية متاحة عن المشاركين لتقدير النتائج المحتملة للأشخاص الذين لم يجروا الاختبار فعلياً. وأتاح ذلك توسيع العينة من نحو 270 ألفاً إلى أكثر من 455 ألف شخص.

• ارتفاع عدد التغيرات الجينية الشائعة. وأظهر التحليل ارتفاع عدد التغيرات الجينية الشائعة المرتبطة باختلاف درجات الاختبار من 390 إلى 550 بزيادة تقارب 40 في المائة. أما التغيرات النادرة، فارتفع عدد الجينات المرتبطة بها من خمسة إلى 26 جيناً، وجميعها ارتبطت بانخفاض درجات الاختبار.

ومن بين هذه الجينات يوجد 14 جيناً سبق أن عُرفت صلتها باضطرابات النمو العصبي، في حين لم تتوافر أدلة قوية سابقة تربط ثمانية جينات أخرى بالقدرات المعرفية أو بهذه الاضطرابات. ولاحظ الباحثون أن معظم حاملي هذه التغيرات النادرة لم يكن لديهم تشخيص باضطراب في النمو العصبي؛ ما يشير إلى أن بعض المتغيرات قد تؤثر في الأداء المعرفي دون أن تؤدي بالضرورة إلى ظهور حالة مرضية تستوفي معايير التشخيص.

• تأثير الجينات يتبدل خلال النمو. وتقدم دراسة أخرى نُشرت في 10 يوليو (تموز) في مجلة Nature Human Behaviour تفسيراً إضافياً لكيفية تطور العلاقة بين الوراثة والقدرات المعرفية. فمن خلال تحليل بيانات 6495 طفلاً ضمن مجموعات بريطانية، وجد الباحثون أن الارتباط بين المتغيرات الجينية الشائعة والأداء المعرفي أصبح أقوى مع تقدم الأطفال في العمر، في حين تراجع نسبياً تأثير المتغيرات الجينية النادرة الضارة. وتشير هذه النتائج إلى أن مساهمة أنواع مختلفة من التغيرات الوراثية في القدرات المعرفية ليست ثابتة طوال مراحل الطفولة، بل تتبدل مع النمو؛ وهو ما قد يساعد على تفسير اختلاف المظاهر المعرفية بين الأطفال حتى عند حملهم تغيرات جينية متشابهة.

الجينات والبيئة والتحصيل الدراسي

• تاثير الدافع وتنظيم المشاعر. وفي دراسة ثالثة نُشرت في الثامن من مايو (أيار) في مجلة Nature Communications بحث العلماء دور المهارات النفسية والسلوكية في العلاقة بين المؤشرات الجينية المرتبطة بالتعليم والتحصيل الأكاديمي.

وتابعت الدراسة 5016 طفلاً في أعمار 7 و9 و12 و16 عاماً، ووجدت أن مهارات مثل «الدافعية» والاتجاهات والسلوك والقدرة على تنظيم المشاعر تفسّر جزءاً من العلاقة بين المؤشرات الجينية والنتائج الدراسية. وتفاوتت النسبة التي أسهمت هذه المهارات في تفسيرها بين أقل من 5 في المائة ونحو 64 في المائة بحسب العمر والتحليل المستخدم.

وتشير النتائج إلى أن العلاقة بين الاستعدادات الوراثية والنجاح الدراسي قد ترتبط أيضاً بمهارات نفسية وسلوكية تتطور خلال الطفولة والمراهقة وتؤثر في طريقة تعلم الأطفال وتفاعلهم مع التحديات.

• الجينات لا تحدد المصير. وعند جمع نتائج الدراسات الثلاث تظهر صورة أكثر شمولاً للتطور المعرفي فبعض التغيرات الجينية النادرة ترتبط بانخفاض الأداء في الاختبارات، لكن تأثير العوامل الوراثية قد يتغير مع العمر كما تتداخل المؤشرات الجينية المرتبطة بالتعليم مع مهارات نفسية وسلوكية تؤثر في التحصيل الدراسي.

ولا تعني هذه النتائج أن الجينات تحدد مستوى ذكاء الإنسان بصورة حتمية أو أن البيئة تلغي تأثير الوراثة. كما لا تصلح هذه النتائج للتنبؤ بقدرات الأفراد؛ إذ تظل الاختبارات المعرفية المباشرة أكثر ملاءمة لتقييم الأداء الفردي.

وتفتح هذه الأبحاث المجال لفهم أعمق لكيفية تطور القدرات المعرفية ولماذا قد يحمل بعض الأشخاص تغيرات جينية مرتبطة باضطرابات النمو العصبي دون أن تظهر لديهم أعراض تستوفي معايير التشخيص، مؤكدة أن فهم الاختلافات المعرفية يتطلب النظر إلى التفاعل بين الوراثة والنمو والمهارات الفردية والبيئة المحيطة.